NiVoca (Legacy)
2026-02-22 ~ 2026-08-06
Intro
NiVocaはクイズ、OCRによる単語認識など、さまざまな機能を備えた日本語単語帳アプリです。
作ったきっかけは、日本語の単語をもっと簡単に入力して追加したいという、自分のための利便性でした。
韓国人としてスマートフォンでは通常韓国語・英語のキーボードを使いますが、日本語が加わると普段の入力の流れから外れ、使いにくくなる問題がありました。
最初は単語入力欄にフォーカスするとIMEを自動で切り替える案を考えました。しかしユーザーの端末を勝手に操作することになるため、その機能はかなり前から禁止されており、諦めてしばらく忘れていました。
最近はAIの発達でバイブコーディングが流行し、アプリやWebサービスをとても簡単に作れるようになりました。そこで、頭の片隅にあった理想の日本語単語帳をバイブコーディングで作ろうと思い、開発を始めました。
最初の要望だったIMEの任意切り替えは依然不可能でした。AIに設計を相談すると、英字をひらがなに自動変換するwaraganaというライブラリがあると言われ、それなら妥協できると考えて開発を進めました。
開発するうちに、画像認識で単語を追加したり、最近出たGemma4のオンデバイスLLMで学習機能を付けたりしたくなり、当初の計画より多くの機能を含む、活用しやすいアプリになったと思います。
開発中に、Web / ReactNativeだけではアプリのネイティブ機能、特にオンデバイスLLMの活用に限界があると感じました。Flutterで全面的に作り直し、Web・React Native版はアーカイブに残すことにしました。
そのため、このリポジトリは認証キーやUIデザイン記録などを除いて公開しました。
バイブコーディングで作ったので品質は保証できませんが、中心的な機能は動くようにしてあるので、参考になればと思います。
プロジェクト
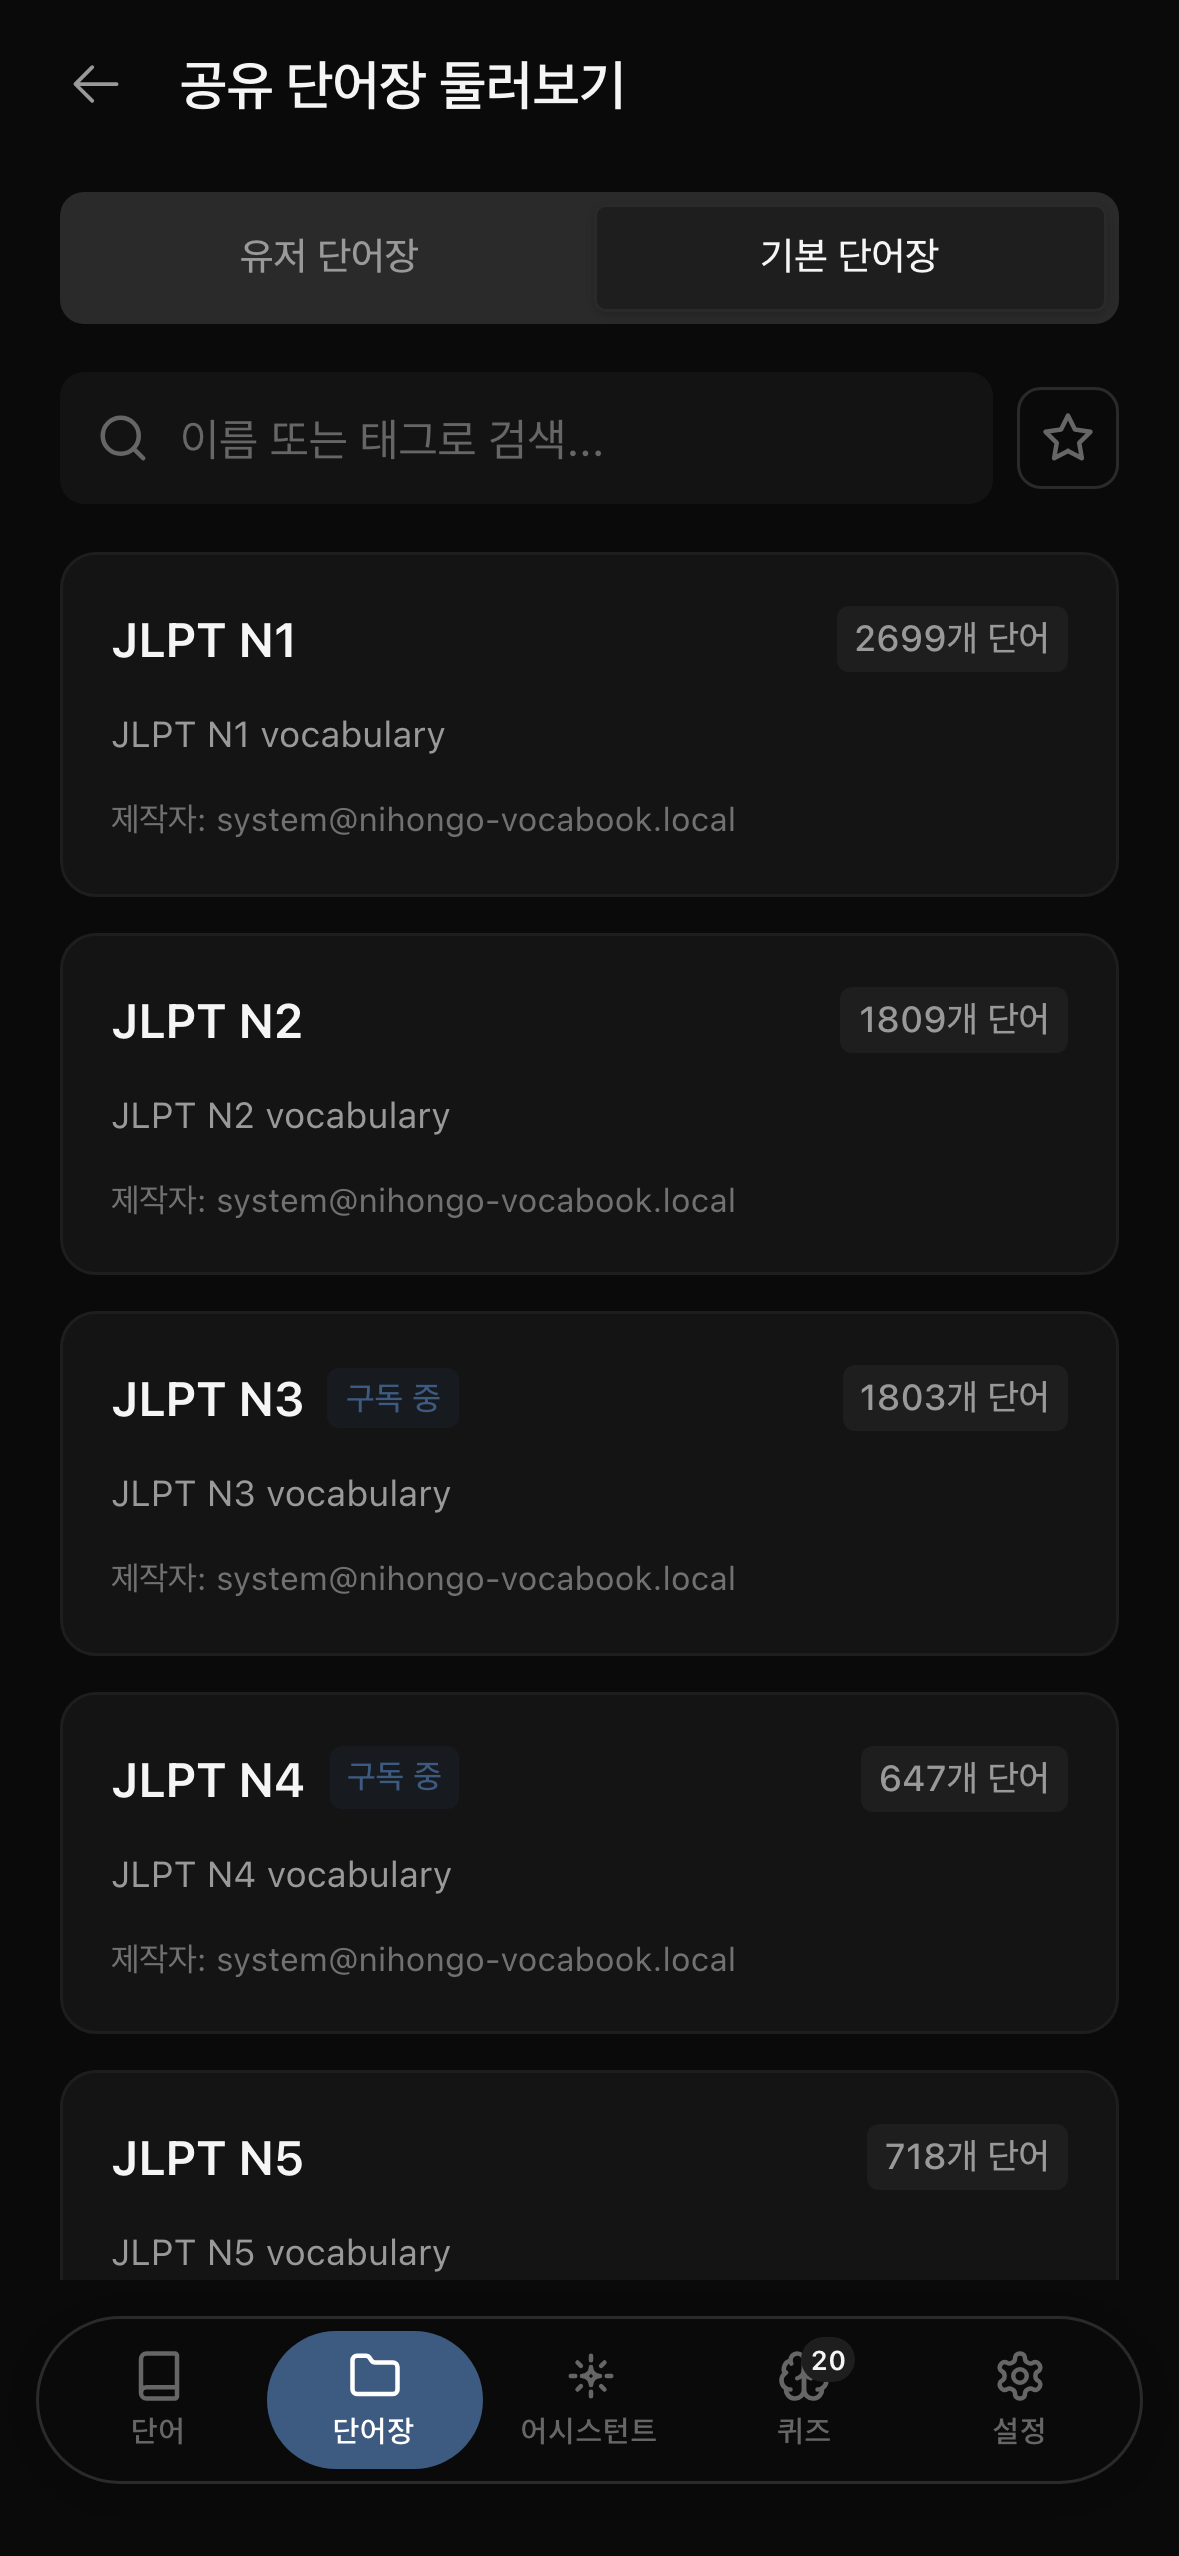
サイトリンク
技術スタック
| 領域 | 使用技術 |
|---|---|
| フレームワーク | Next.js 16 (App Router, Turbopack) |
| UI | React 19, Tailwind CSS 4, shadcn/ui (Radix) |
| 状態管理 | Zustand(認証・スキャン)、それ以外はローカルstate |
| データ | Supabase(ログイン) |
| 間隔反復 | FSRS (ts-fsrs) |
| OCR | Tesseract.js、LLM Vision、オンデバイスGemma (LiteRT-LM) |
| ネイティブシェル | Expo 55 + React Native WebView |
| テスト | Vitest, Playwright |
| デプロイ | GitHub Actions → Docker → Nginx(個人Linuxサーバー)→ CloudFlare |
| パッケージマネージャー | Bun workspaces(モノレポ) |
モノレポの構成は次のとおりです。
nihongo-vocabook/├── apps/web/ # Next.js PWA (본체)├── apps/mobile/ # Expo iOS 앱 (WebView + 네이티브 기능)└── supabase/ # 마이그레이션 / 시드開発の過程
初期の技術選定
- Next.js + PWA
- アプリ開発経験は7年前にFlutterを少し使った程度だったため、慣れたWebで進めた
- アプリのような使い勝手はPWAで代替
- Supabase
- 個人プロジェクトの認証・DB・RLSをまとめて解決
- 簡単に開発でき、バックエンドを大きく気にしなくて済むため採用
- Bun
- nodeとpnpmの組み合わせより速いと聞いて試した
- ライブラリはすべて最新版を使用。個人プロジェクトでバージョン制約がないので新技術を採用
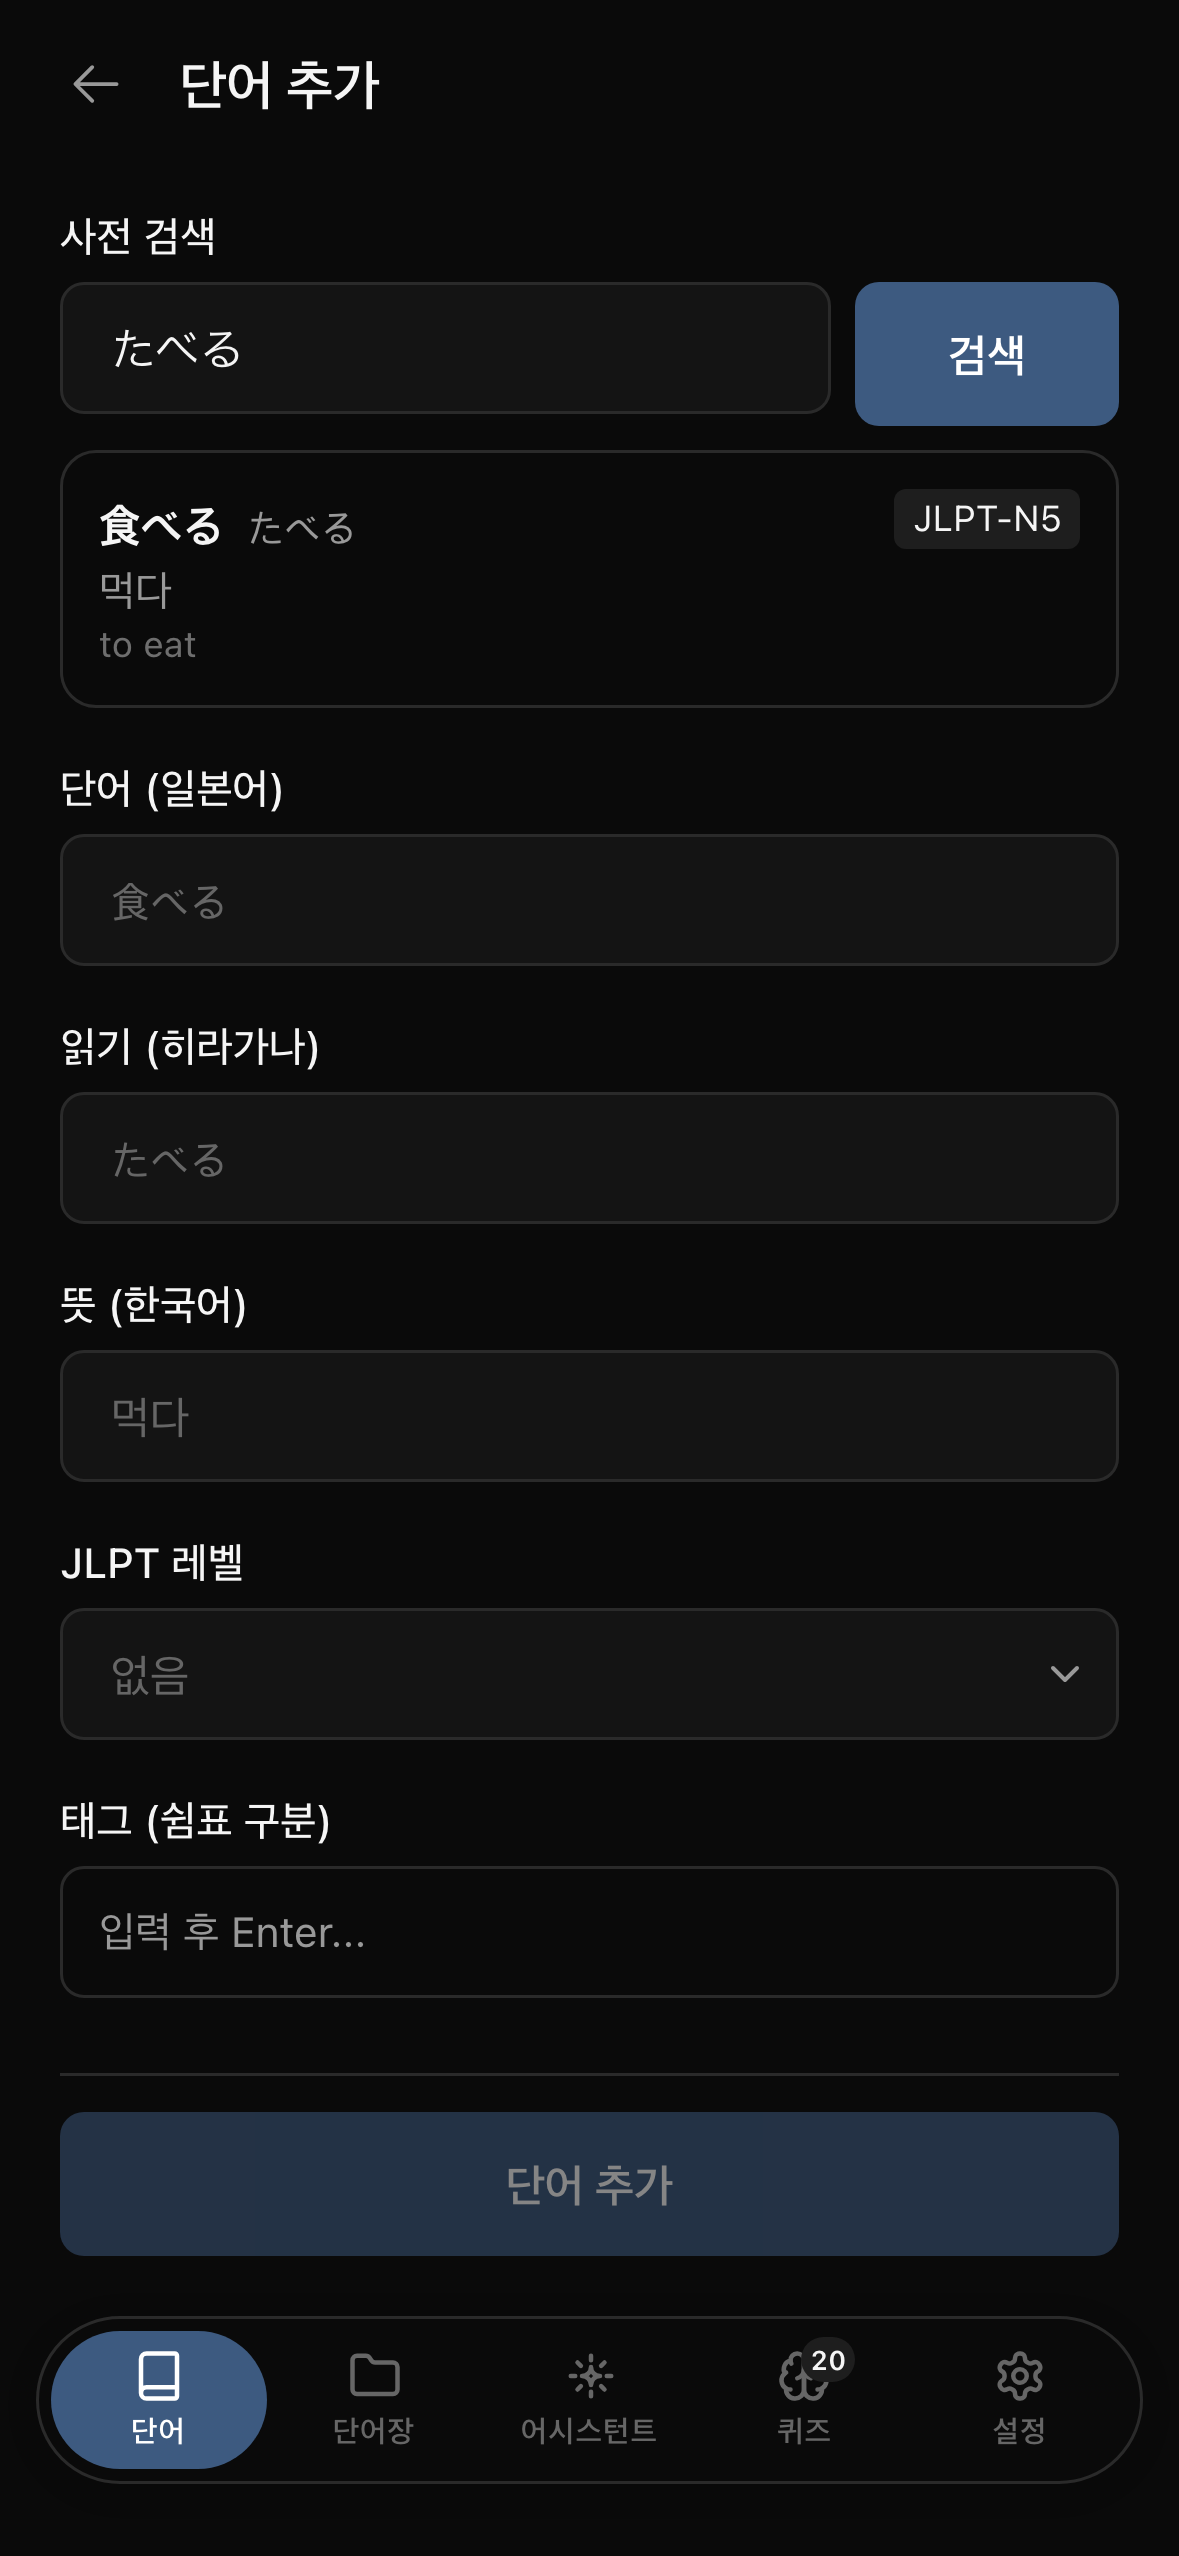
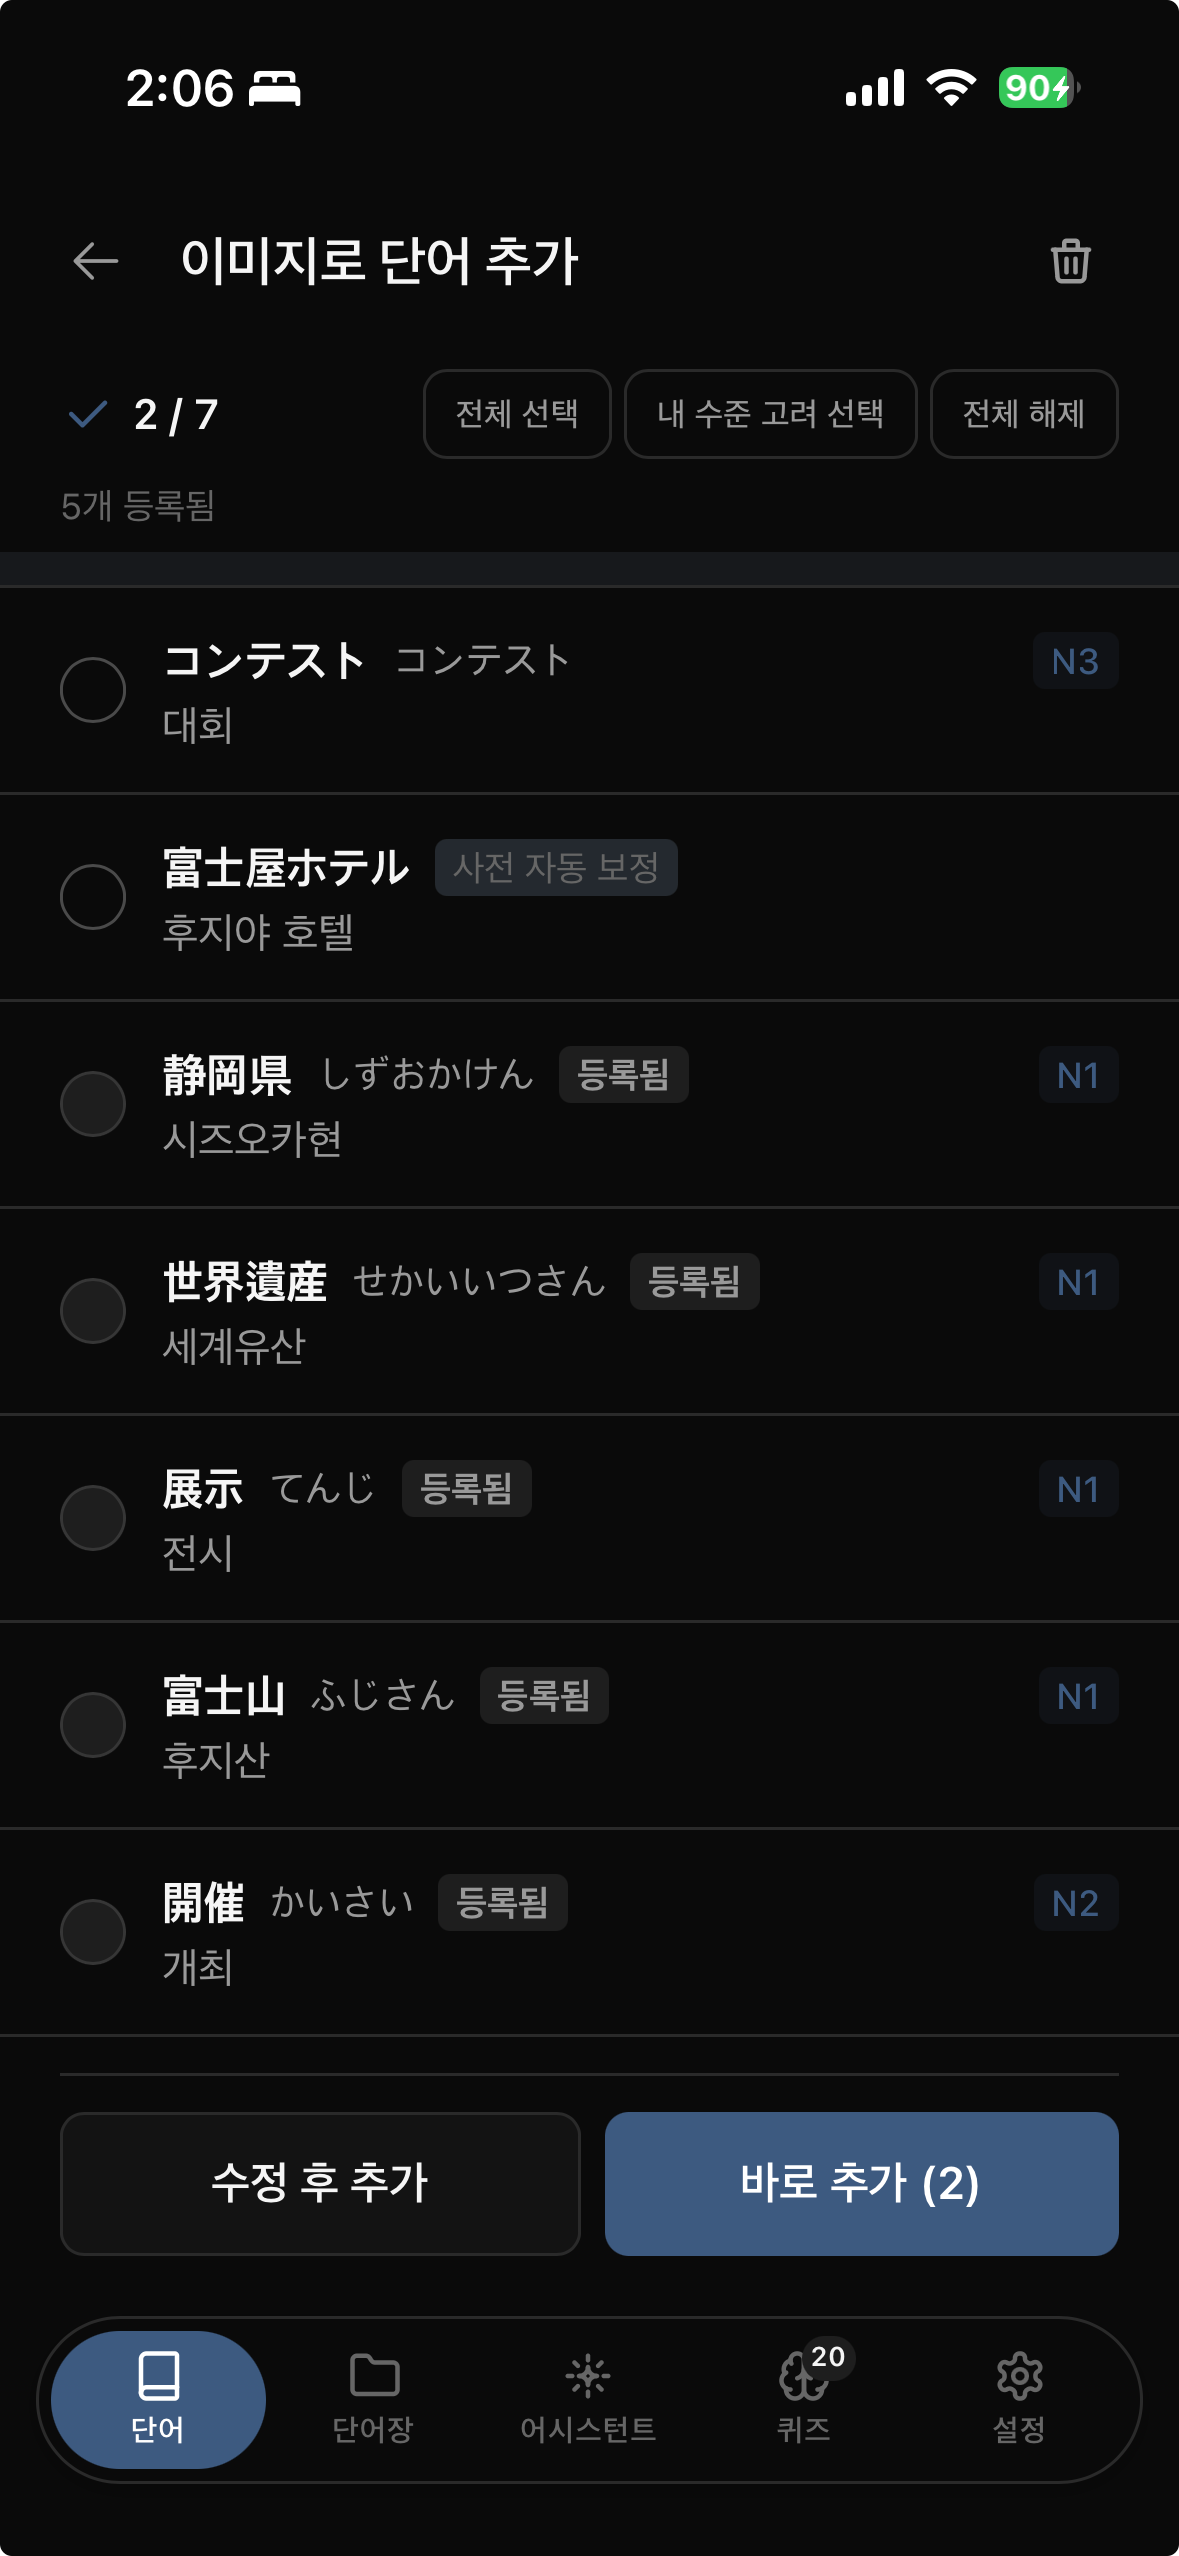
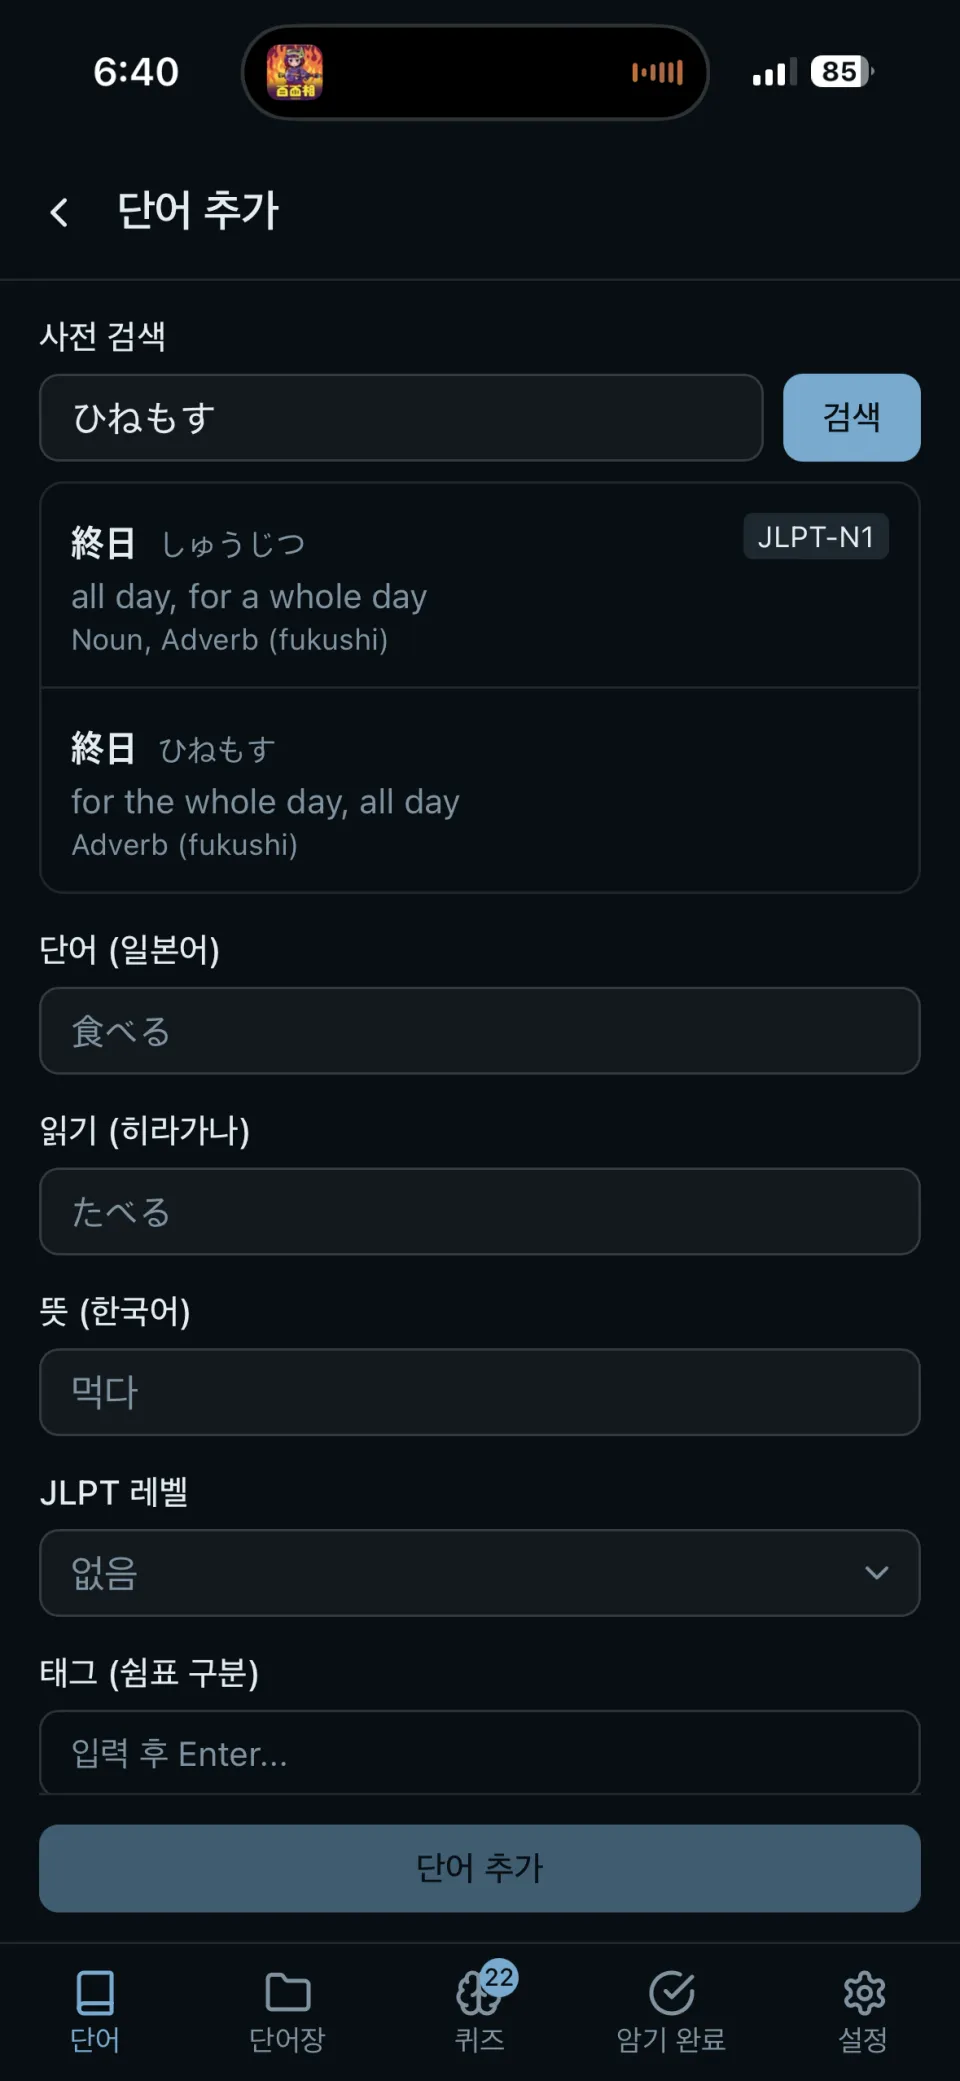
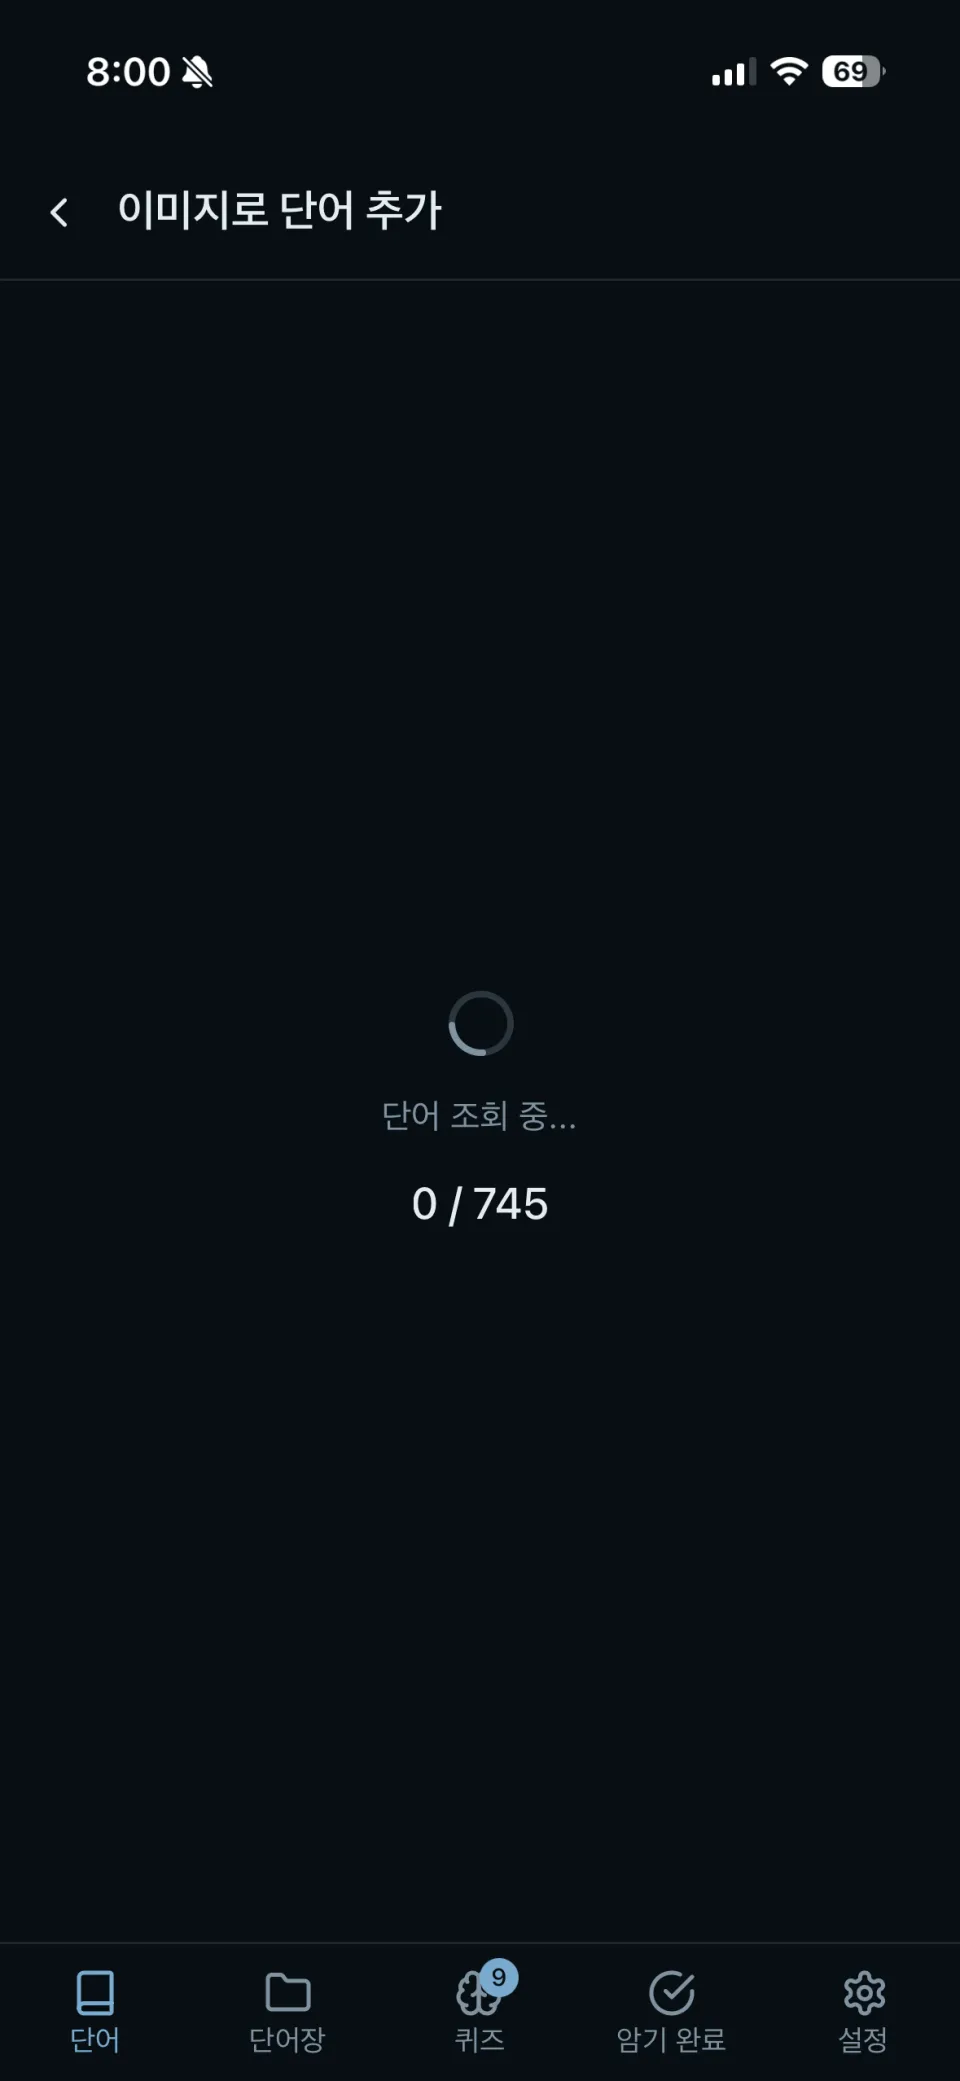
初期画面はこのようなものでした。辞書検索結果を選ぶと単語・読み・意味が入り、アルファベットの入力はwaraganaを通ってひらがなになります。
| 単語追加(辞書検索) | 画像OCRで単語追加 |
|---|---|
 |  |
初期設計
- ログインなしでも利用可能
- 単語・単語帳・クイズ・設定にIAを構成
- 暗記時はflipで「単語のみ」と「単語+意味」を切り替え
- クイズ設定
- 初期はsrs
- 違和感がありAIと相談した末、fsrsの構成をカスタムして活用(そのままでは実装したUI/UXに合わなかった)
- waraganaでアルファベットからひらがなを入力
- オープンソースの日本語・英語データを取り込み、LLM(claude sonnet)で韓国語へ翻訳
- 単語検索はDBの辞書、なければJisho api、それでもなければLLM(gpt5)を使い、そこにもなければ結果なし
- DB・認証はSupabaseに任せる
ただし1番のログインなしでの利用は、後に撤回した。
最初はゲスト用ストレージをIndexedDB(Dexie)で別に作り、ログイン状態でRepositoryの実装を切り替えていた。
しかし、ゲストのデータをログイン後にサーバーへ移すマイグレーションまで扱うと、状態管理が手に負えなくなった。
結局、ゲスト保存をすべて外し、ゲストモードを廃止した。
クイズと間隔反復
単語を入れる部分より、むしろここに時間を使った。
SM-2からFSRSへの切り替え
- 最初はAnki系の古典的アルゴリズムSM-2を自作したが、復習間隔が感覚に合わなかった
ts-fsrsへ変更。アルゴリズムのパラメーターは標準のまま、カスタムは上のUI/UX層だけで行った- 移行の名残もある。
study_progress.ease_factorはSM-2時代のフィールドでFSRSは使わないが、カラムは残っている
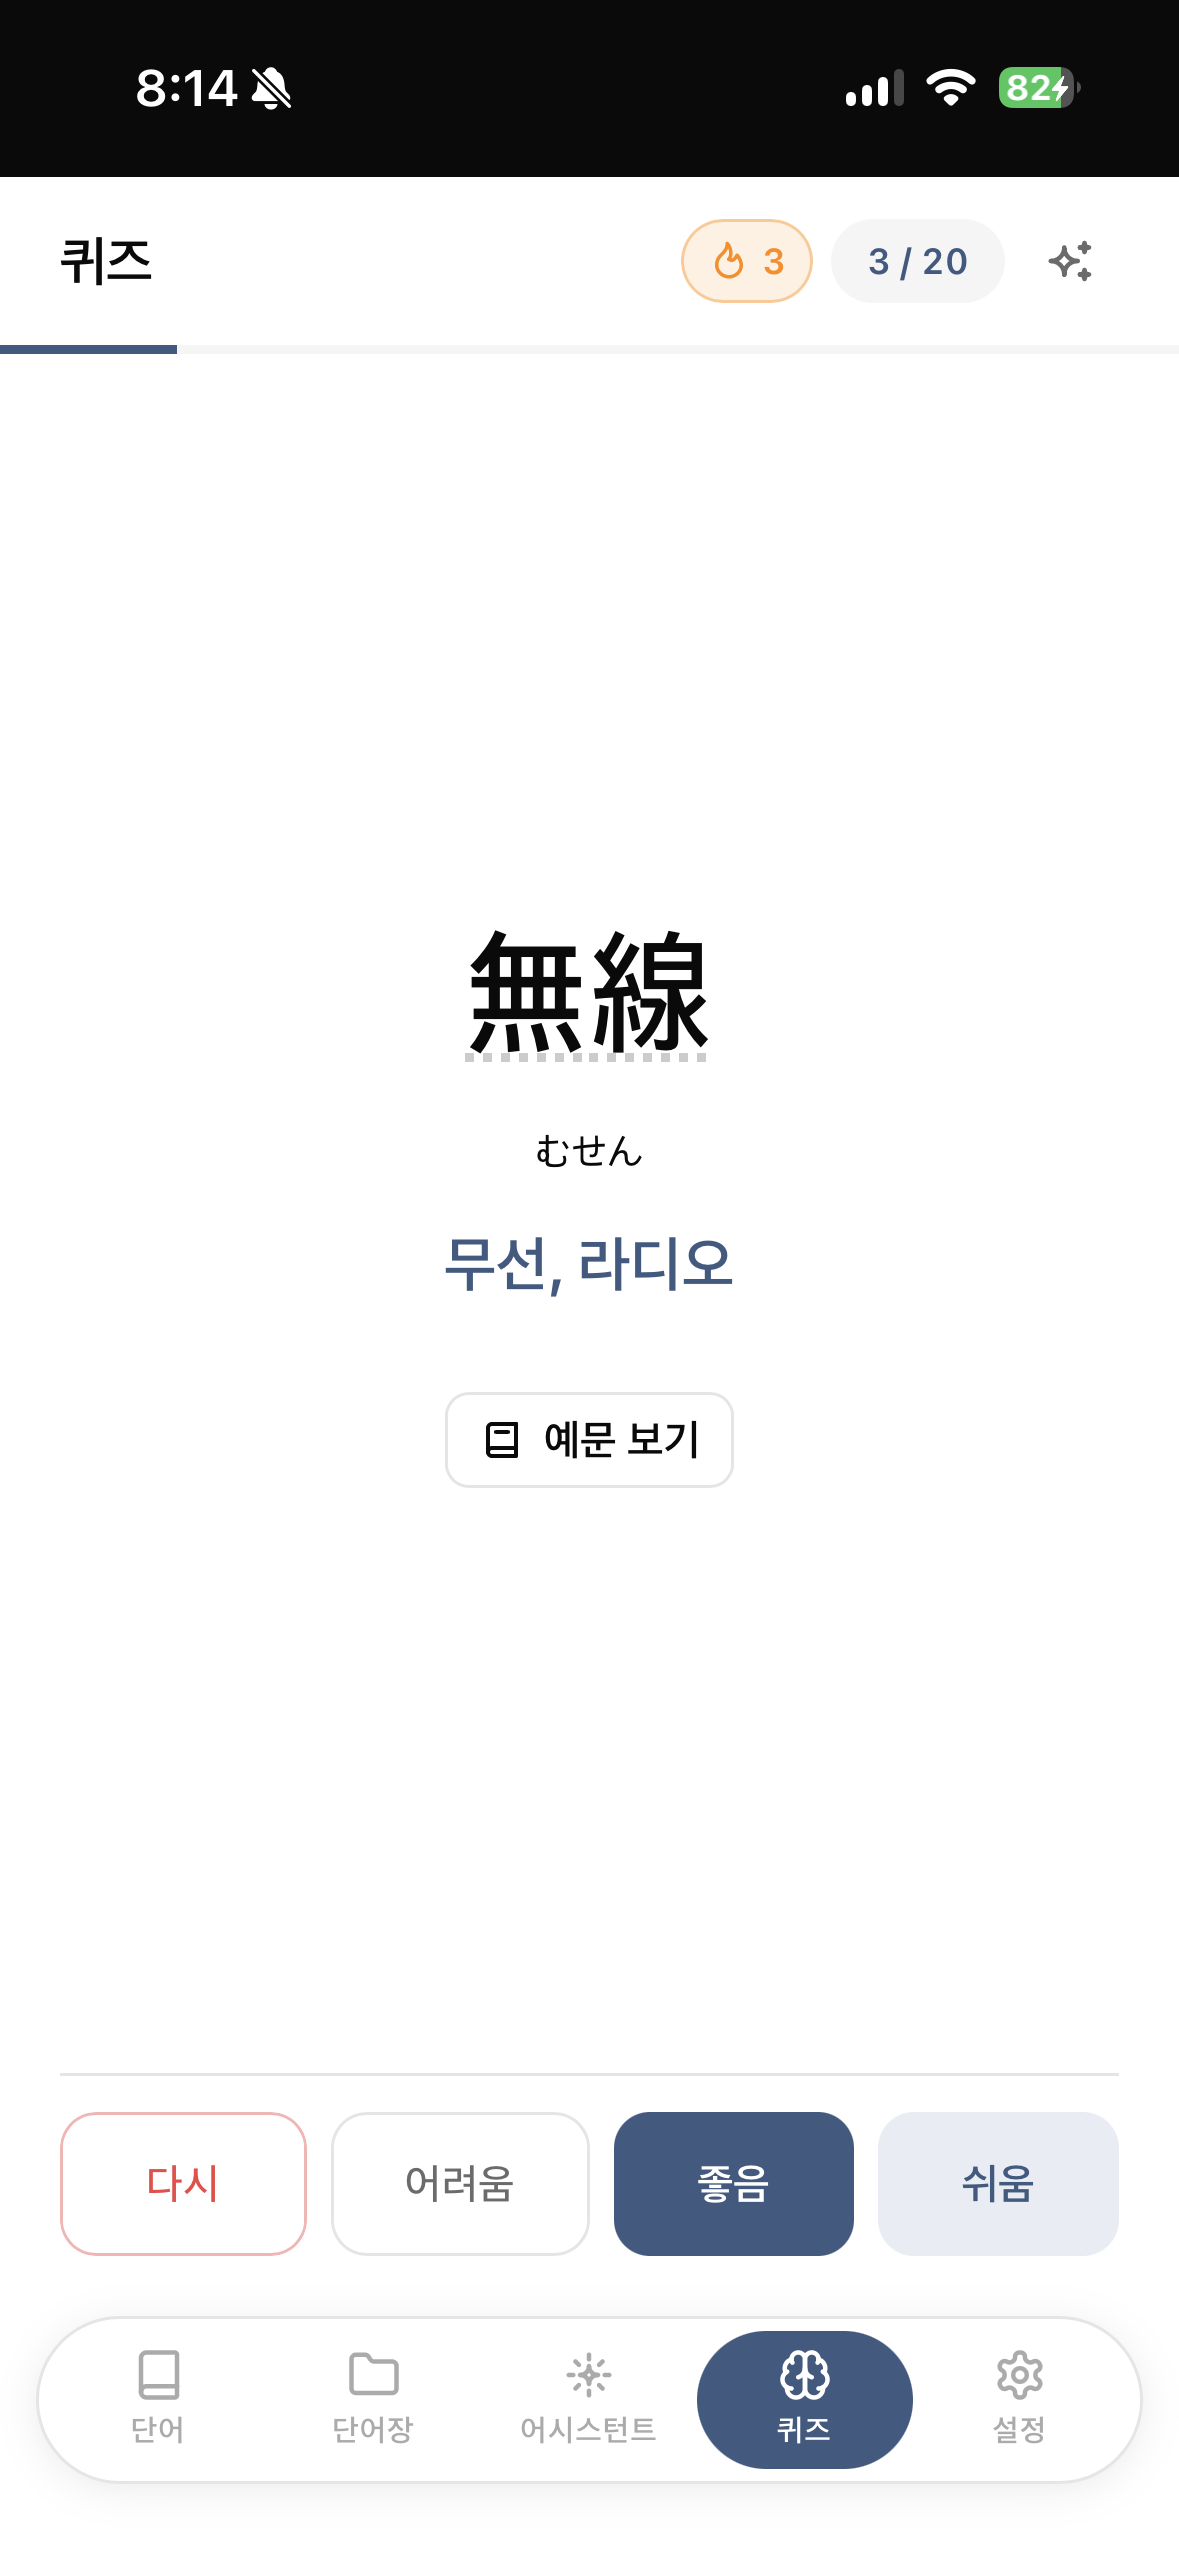
4段階の評価と次の間隔のプレビュー
- Again / Hard / Good / Easyの4ボタン
- 押す前に、それぞれのボタンで次の復習がいつになるか表示(「Easy = 20日後」など)
- 評価を感覚だけで選ばないため
2種類のカード
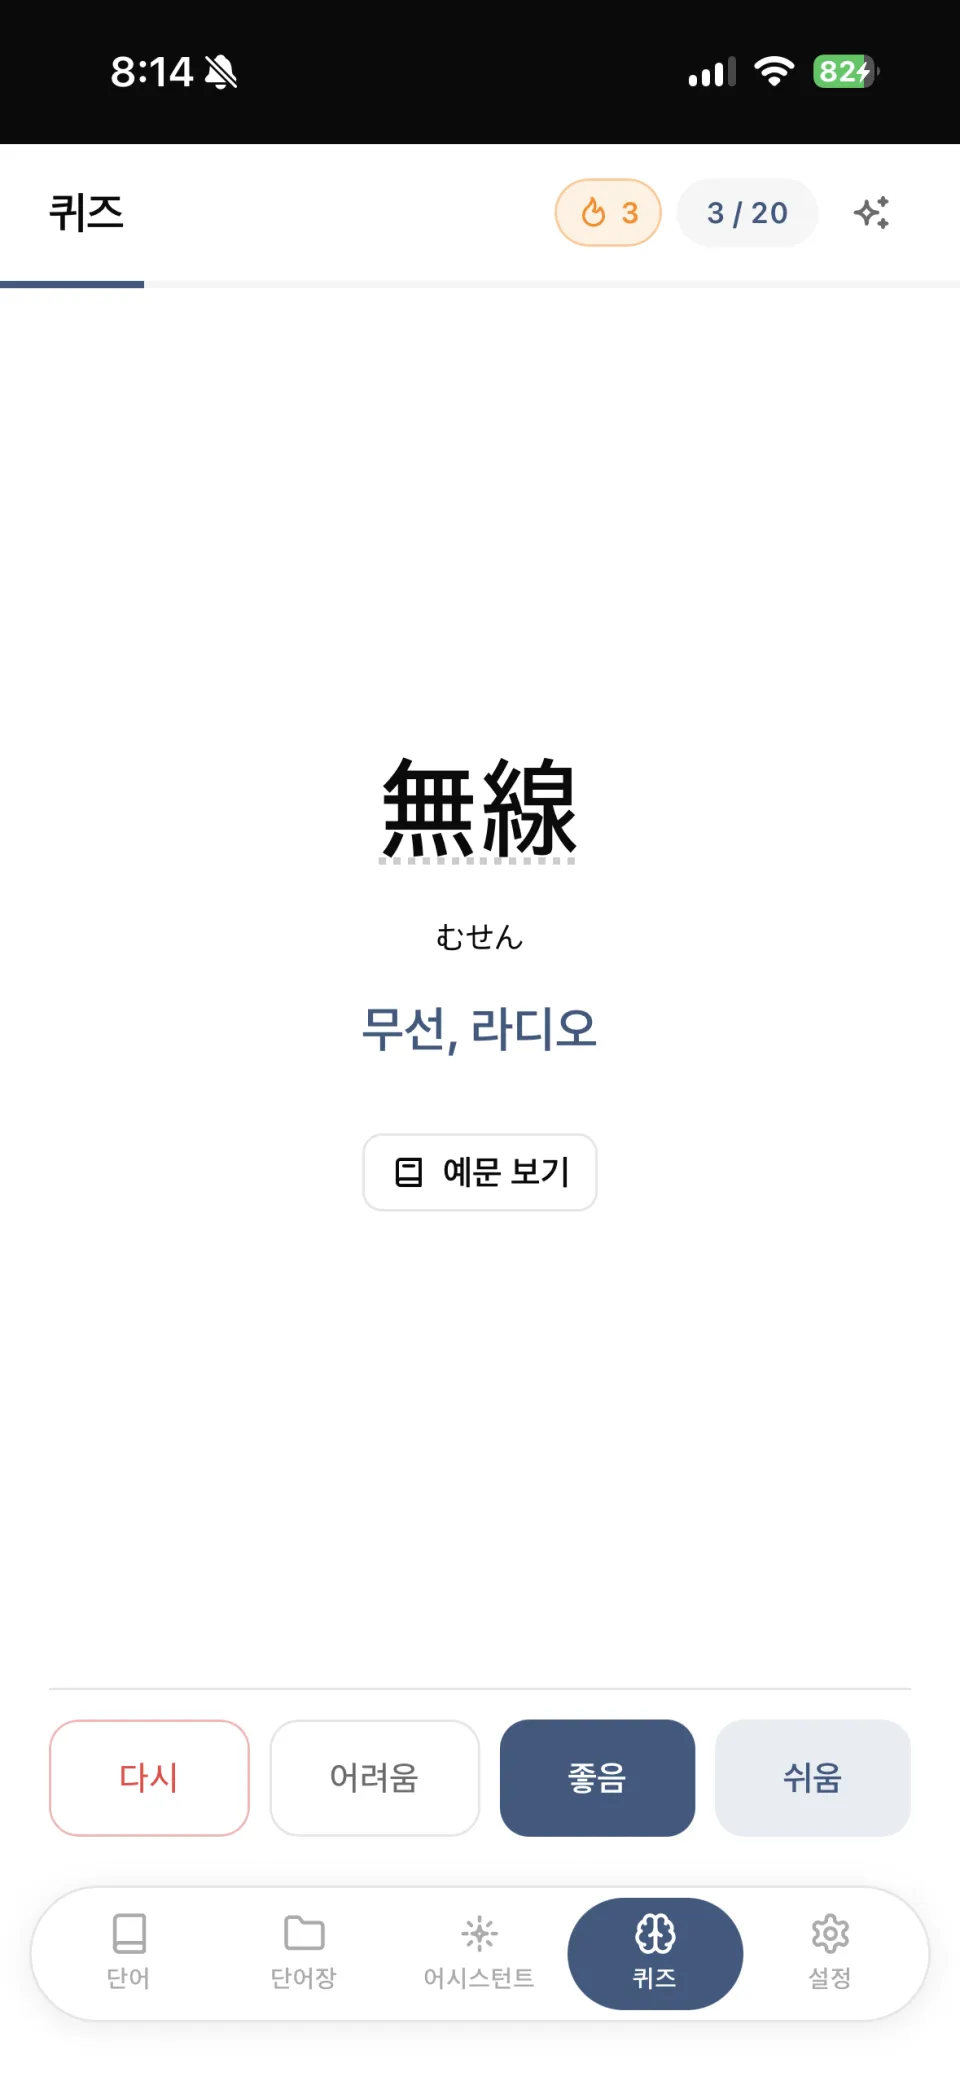
- 単語カードはflip形式。向きは単語→意味、意味→単語、ランダムから選択
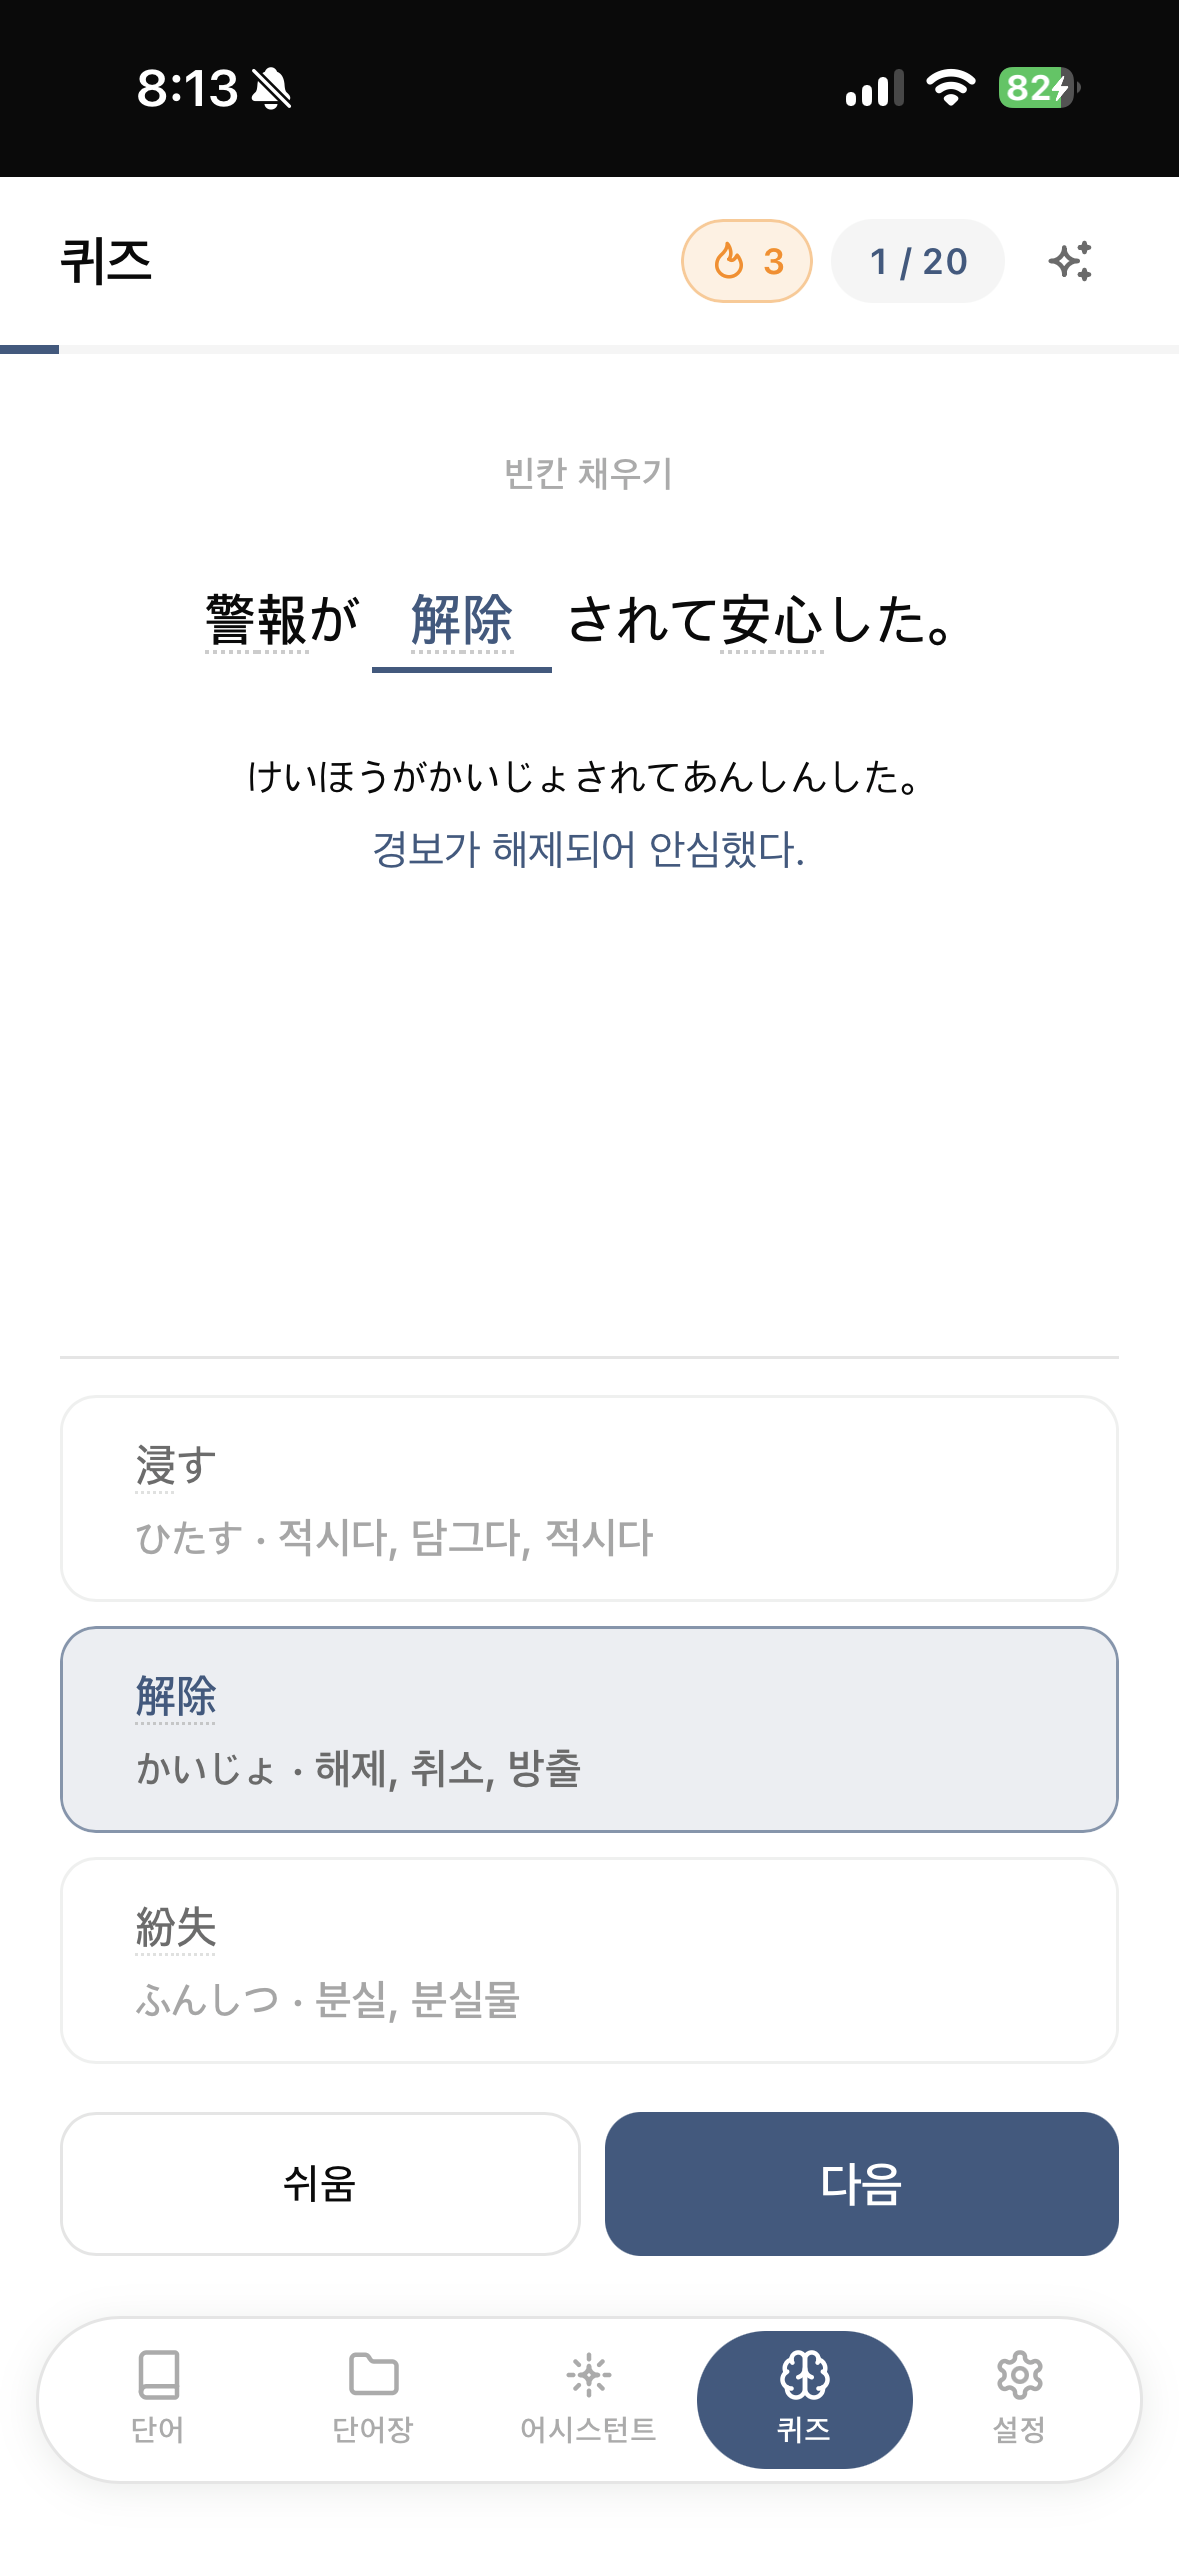
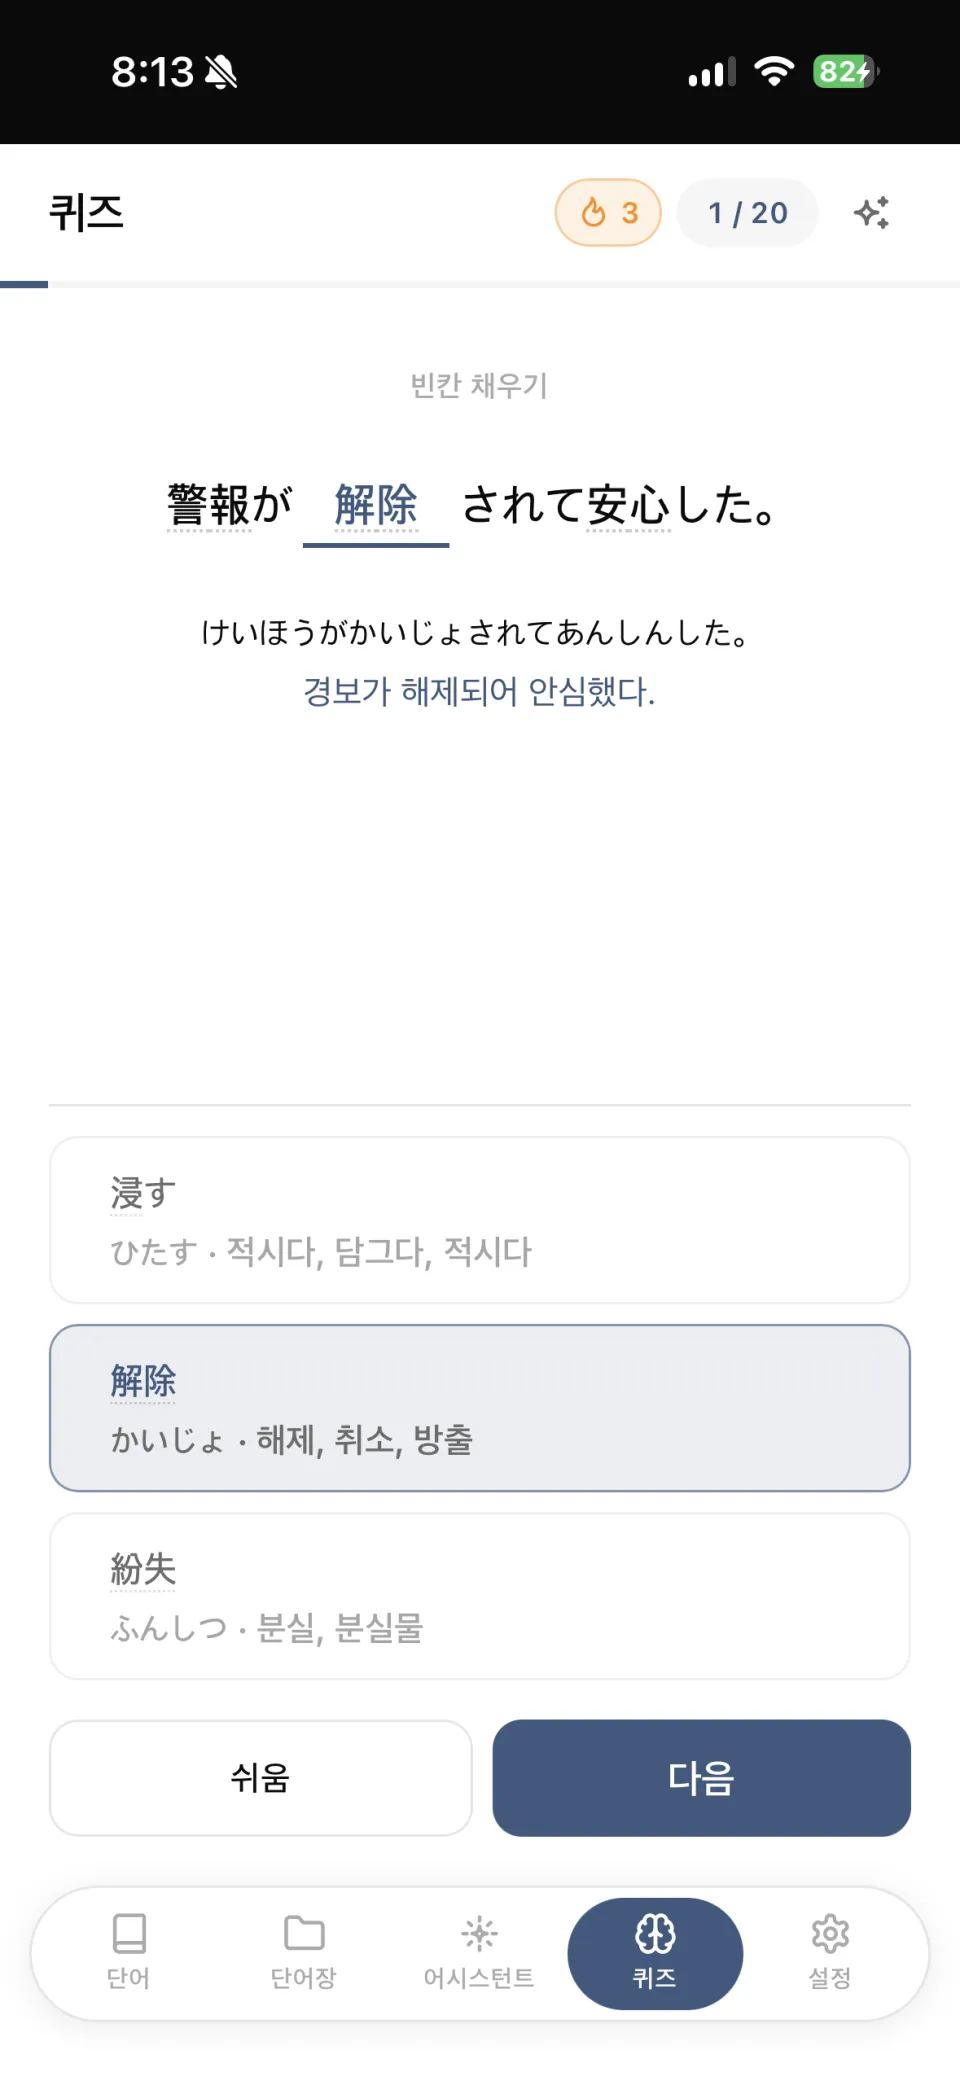
- 例文穴埋めカードは対象語を
____で隠し、3択にする(誤答2つは他の単語から選ぶ)。基本比率30%で、設定から変更可能
どこを穴にするかは思ったより難しかった。辞書形(食べる)が例文では活用形(食べます)になるため。
- 辞書形が文にそのままあれば、それを使う
- なければ末尾のひらがなを一文字ずつ除き、漢字が残る部分を探す(
食べる→食べ) - 漢字のない単語(
する、できる)は諦めてカードを捨てる
今日出す問題を選ぶ基準
優先度の重み × JLPTレベルの近さ × 延滞倍率の積を取り、点数順に並べる。
- 優先度: 高1.0 / 普通0.7 / 低0.4
- 延滞倍率: 未延滞0.8、3日以内1.0、1週間超1.5
使ううちに、同点の単語がいつも同じ順番で選ばれるのが気になった。
- 最終点数に±15%のジッターを掛け、同点をランダムに分ける
- 優先度・延滞による差(通常1.4〜3倍)はジッターより大きいため、急ぎのカードが後ろには回らない
- 新規カードは入力順に偏っていたため、DBからランダムに取得するRPCを別に作った
自動習得済み / leech
- Easyが2回連続すると自動で「暗記完了」にしてキューから除外
- 逆に間違い続ける単語はleechとして表示(基本8回、設定可能)
セッションの復元
- クイズの途中でアプリを閉じても続けられる必要があった
- localStorageには単語IDの順序と現在位置だけ保存。例文・誤答選択肢は重いため、読み込み時に再生成
- 日付が変われば破棄
正答率は加重平均
正解・不正解の二択ではなく、「どのくらい確実に知っているか」で集計。
| Again | Hard | Good | Easy | セッション中の習得 |
|---|---|---|---|---|
| 0 | 20 | 50 | 80 | 100 |
他にも日次目標(基本20語)、JLPT・優先度フィルター、学習リマインダー、22種類の実績(単語数・連続学習日・累計復習数・ミスなしセッションなど)を設定で調整できるようにした。
| 単語カード(flip) | 例文穴埋めカード(3択) |
|---|---|
 |  |
機能の拡張
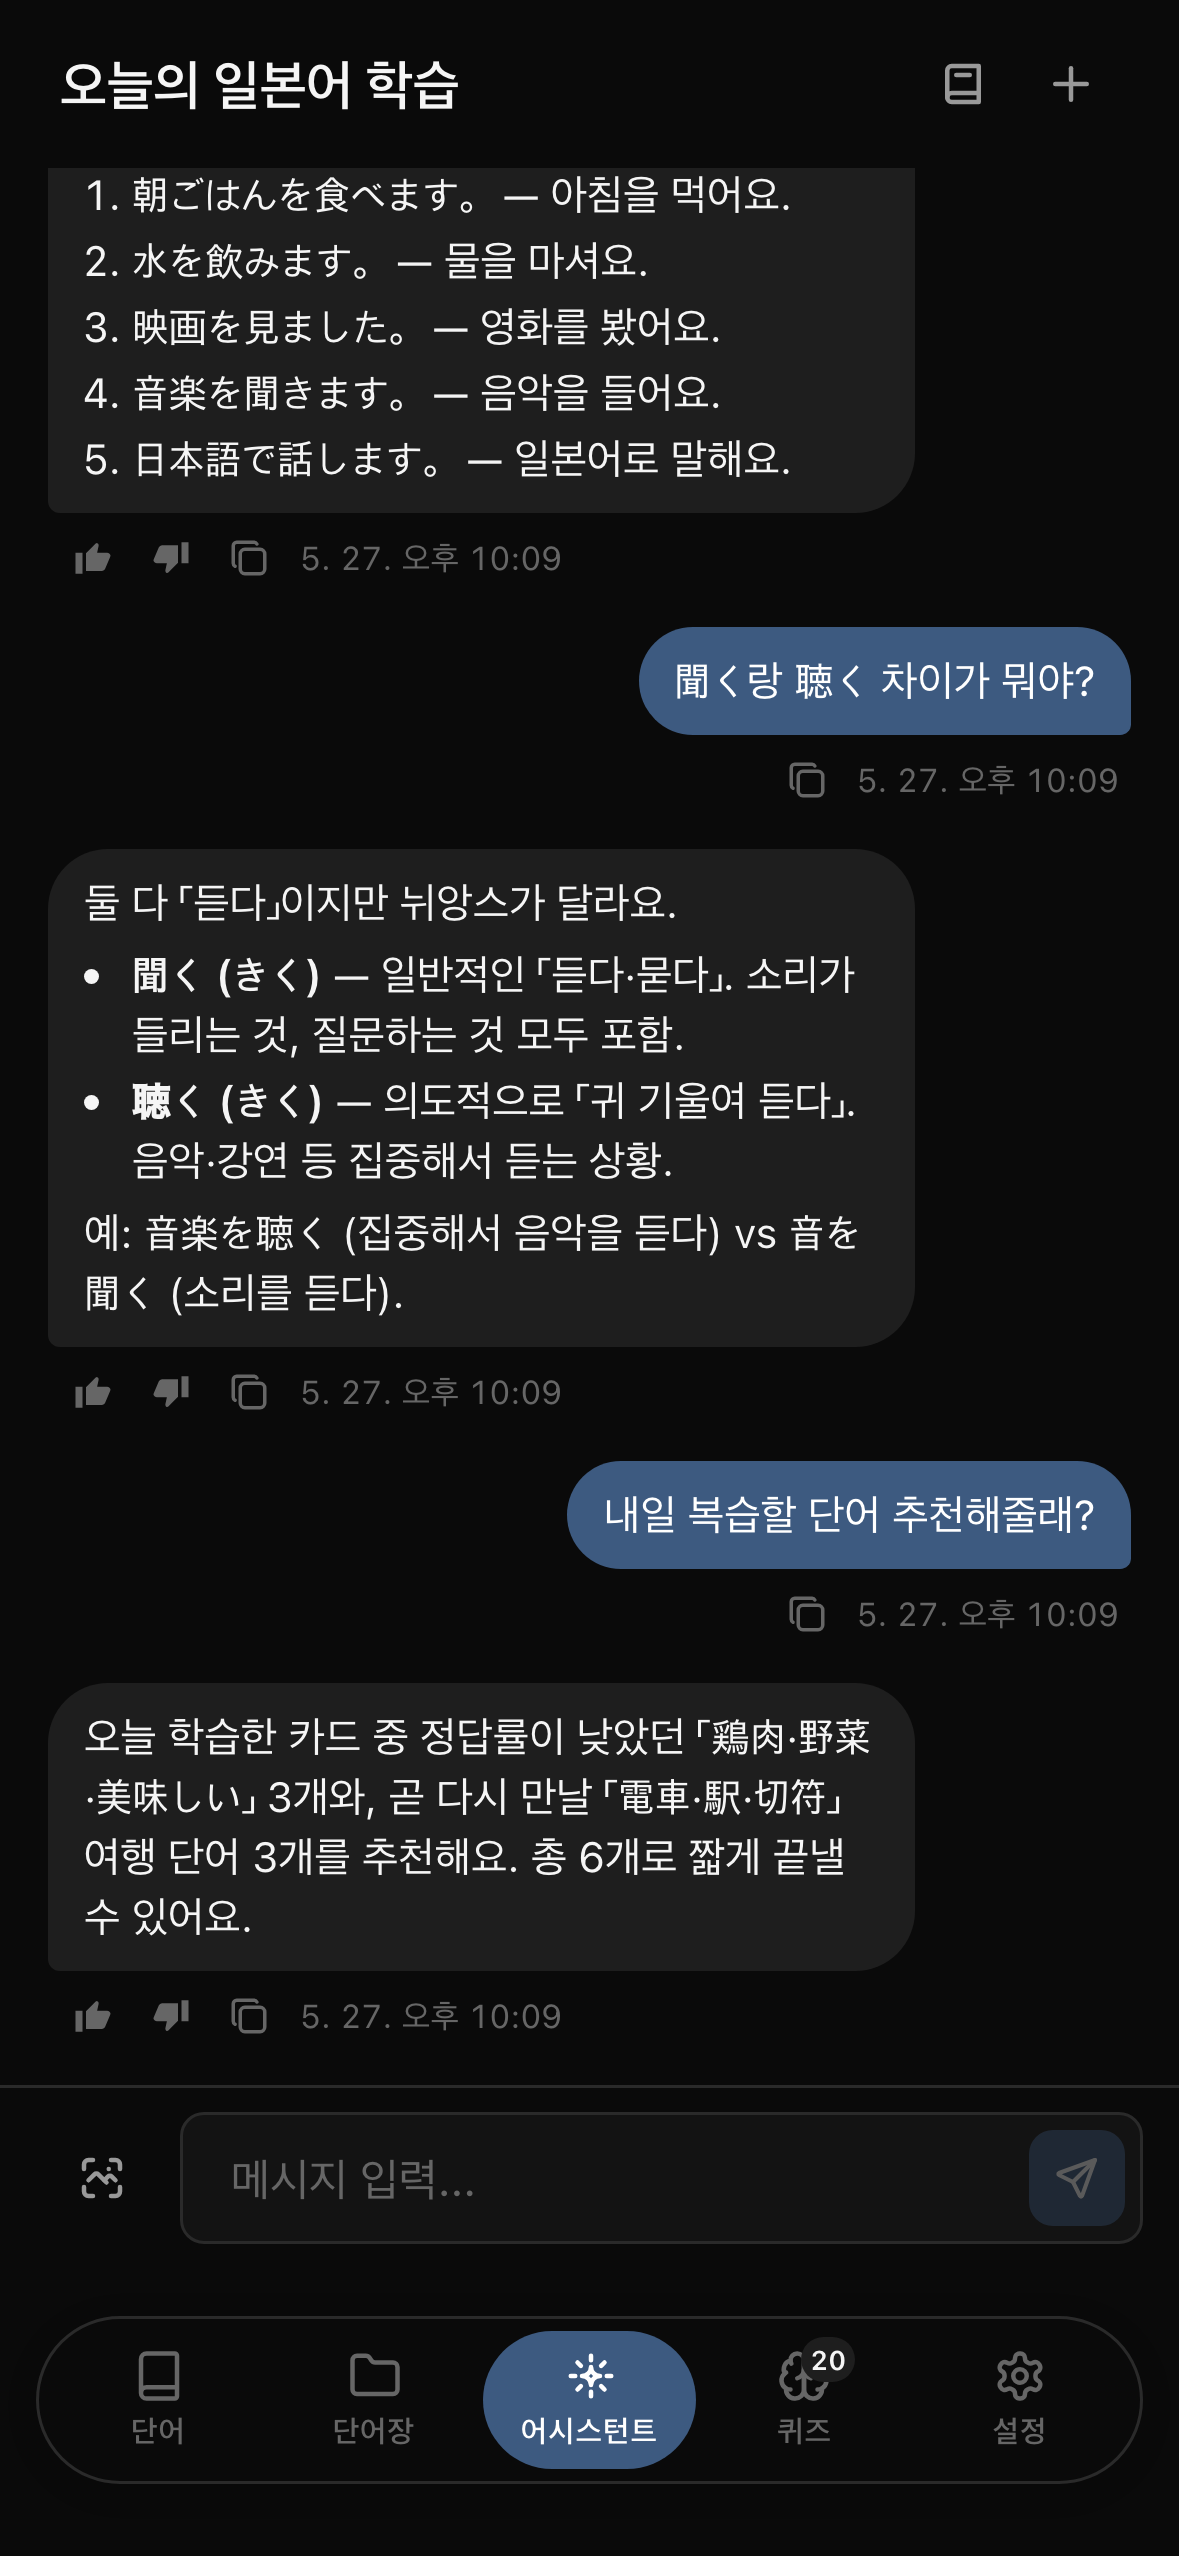
- On device LLM(Gemma4)でOCRを強化し、AIと日本語を学ぶ機能
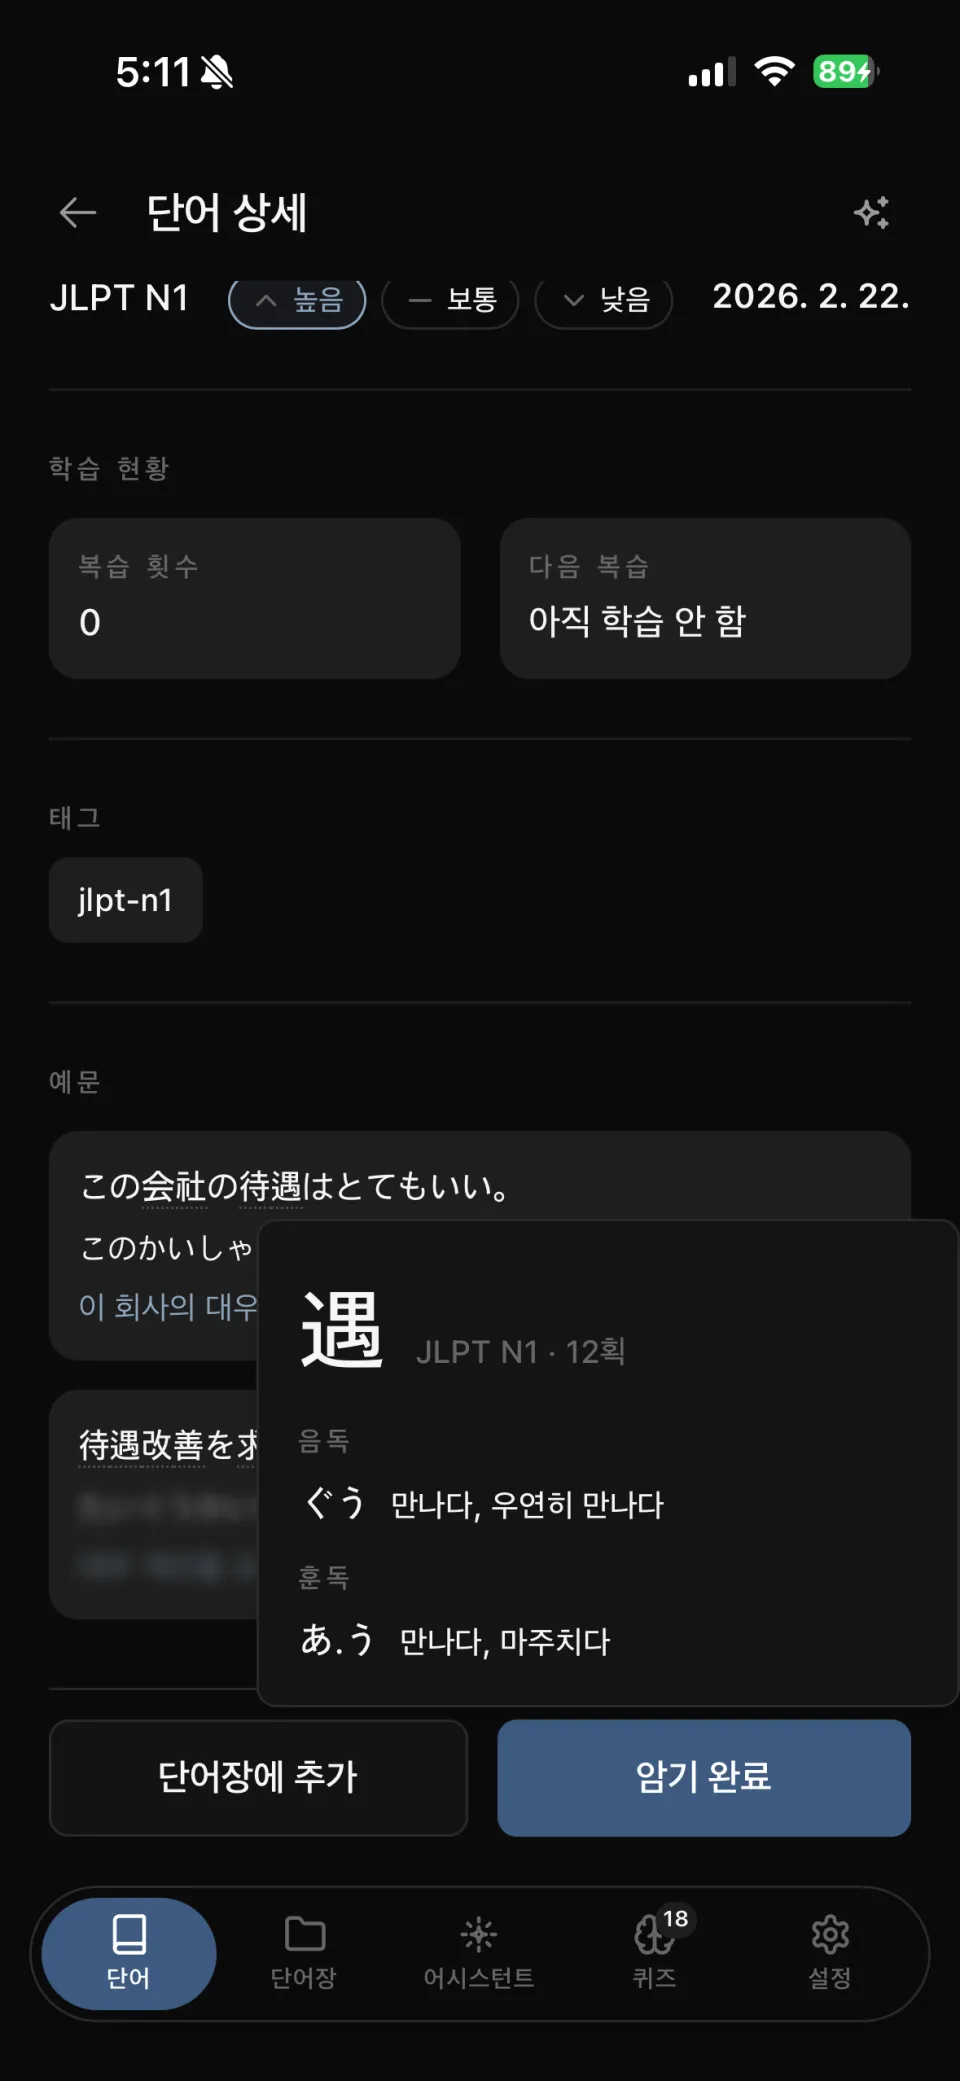
- 単語内の漢字を押すと、その漢字の訓・音に応じた意味と読み仮名を表示
- 単語ごとの例文を提供
- 漢字・例文データはLLM(claude sonnet)で生成
- UI/UXの全面改修
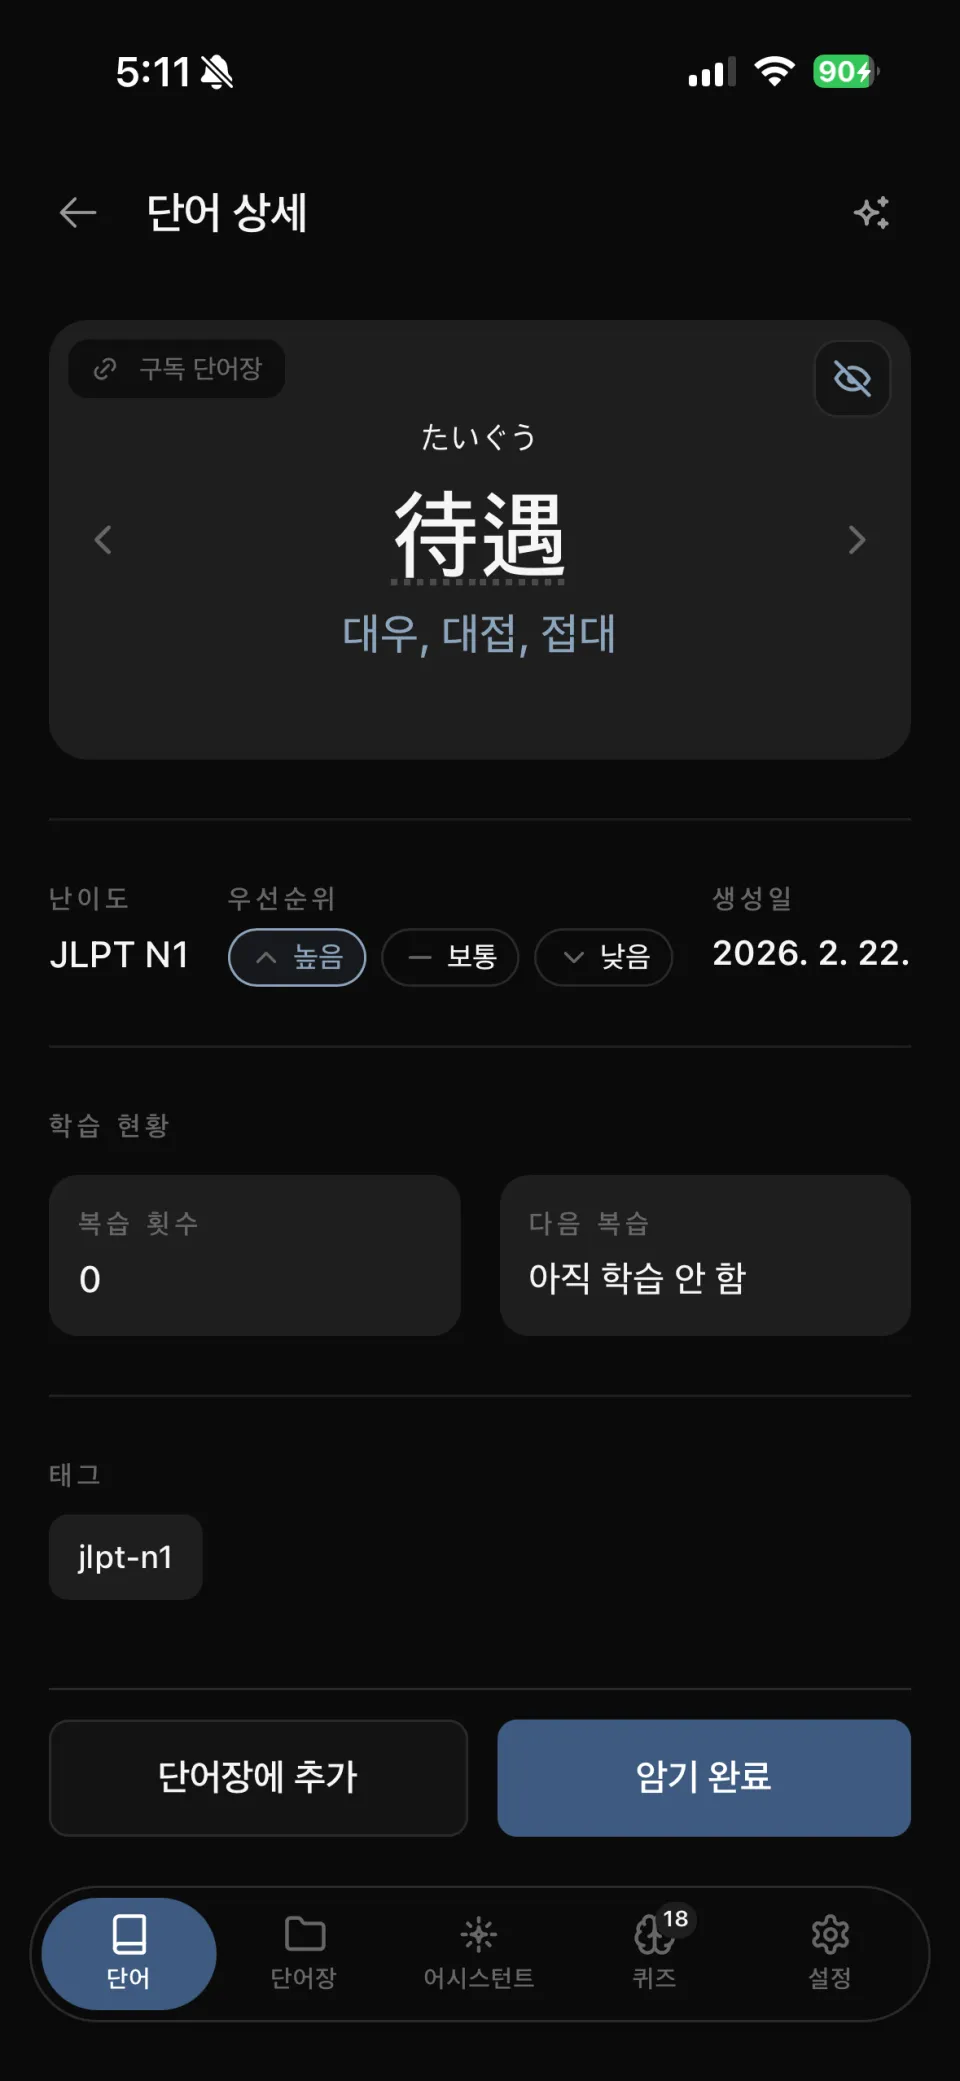
単語詳細で漢字を押すと、その場で音読み・訓読みと意味が開きます。例文には振り仮名と韓国語訳を付けました。
| 単語詳細 | 例文・漢字の音読みと訓読み |
|---|---|
 |  |
UIは一度に作り直したのではなく、継続して手を入れた。そのため、この記事のスクリーンショットも撮影時期が異なり、少しずつ違う。
- 下部タブは、オンデバイスLLMの追加に合わせ「暗記完了」から「アシスタント」へ変更
- タブバーは、画面下に付いた平らなバーから、アクティブタブのpill、バー全体が浮くカプセル型へ
- 単語詳細では難易度・優先度・学習状況を一画面に示し、購読単語帳のバッジを追加
この時期にロゴも作り直しました。
| 初期ロゴ | 改修後 |
|---|---|
 |  |
React NativeとExpoの導入
- Web環境ではメモリーが1gbに制限され、オンデバイスLLMに適さなかったため移行
- next.jsの成果物を再利用するにはRNが適していた
- App Storeへ簡単に公開できるexpoも使ってみることにした
正確には画面をRNで作り直したのではなく、既存のNext.js WebをWebViewで包んだシェルです。 画面とロジックはWebの成果物をそのまま使い、カメラ・通知・オンデバイスLLM推論などネイティブが必要な部分だけをブリッジ経由で扱いました。
[ Next.js (WebView) ] ←→ bridge ←→ [ Expo Native ] 화면 · 로직 카메라 / 알림 / on-device LLM現プロジェクトの凍結とFlutterへの移行
- RNの使い勝手の悪さ:
- バイブコーディングで最適化が不十分だったせいかもしれないが、妙に引っ掛かる部分が多かった
- js -> swiftという層が一つ増え、ネイティブ機能を十分に活用しにくい
- オンデバイスLLM活用の制約
- ネイティブではないため微妙に動かない部分が多かった。本来iphone15pro程度ならgemma4 e4bを使えるメモリーがあるのに、e4bではアプリが落ちた
- e2bは小さいモデルなので変な答えを出し続ける。1,000文字以上のプロンプトで正常に動かず、function callingも正しくできなかった
- Expoの不便さ
- freeプランにはビルドの制限がある => サイドプロジェクトなので有料プランの契約は少し負担だった
- ビルドの優先順位が低く、1時間後に始まることもあった…
- freeプランにはビルドの制限がある => サイドプロジェクトなので有料プランの契約は少し負担だった
以上の理由からプロジェクトをアーカイブし、Flutterへ全面的に移行。
flutterを選んだ理由はios/androidを同時にサポートでき、クロスプラットフォームながらネイティブに近いため。
Public Archive化
privateのままにするのはもったいなく、ブログ記事にもしようと思い、機密部分だけを除いてpublic archiveにすることにした。
“_docs”や”_note”フォルダーには、このプロジェクトでAIと議論した内容や計画がすべて残っている。
デプロイ環境
ブログと同様、個人のLinuxサーバーにself-hosted runnerを置いてデプロイ。
- ビルドはGitHubホステッドランナーで実行し、アーティファクトをアップロード
- デプロイはself-hostedランナーがアーティファクトを受け取り、Dockerイメージをビルドしてコンテナを交換
- NginxリバースプロキシとCloudflareのドメイン接続
振り返り
よかったこと
- バイブコーディングによる素早い開発 => OCRの変更、ゲストモードの撤回、RNへの移行も「試して判断」できる速さだったので、意思決定が遅れなかった。
- 辞書をオープンソースとLLM翻訳で埋めたこと。個人プロジェクトで何万語も手入力するのは無理だった。
- ともかくApp Storeの審査を通して公開したこと。 サイドプロジェクトはローカルで動くところで止まりがちだが、ストア登録・審査・デプロイの流れを一度通した経験は残った。
反省点
- オンデバイスLLMを機能の前提にしてしまったこと。 モデルが動くかを先に確認してから機能を設計すべきだったが、順序が逆だった。 結局e4bはメモリー不足で落ち、e2bは品質が出ず、作った機能をモデルの能力に合わせて削る作業を繰り返した。
- IndexedDBまで実装してからゲストモードを撤回したこと。着手前に状態管理の複雑さを見積もれていなかった。
- SupabaseのトリガーやRPCにドメインロジックを一部流したこと。 当初は楽だったが、バックエンドを自前運用すると決めた際に、そのまま移行コストになった。
- バイブコーディングの代償。「動く」と「検証した」を分ける規律が身に付くのが遅かった。
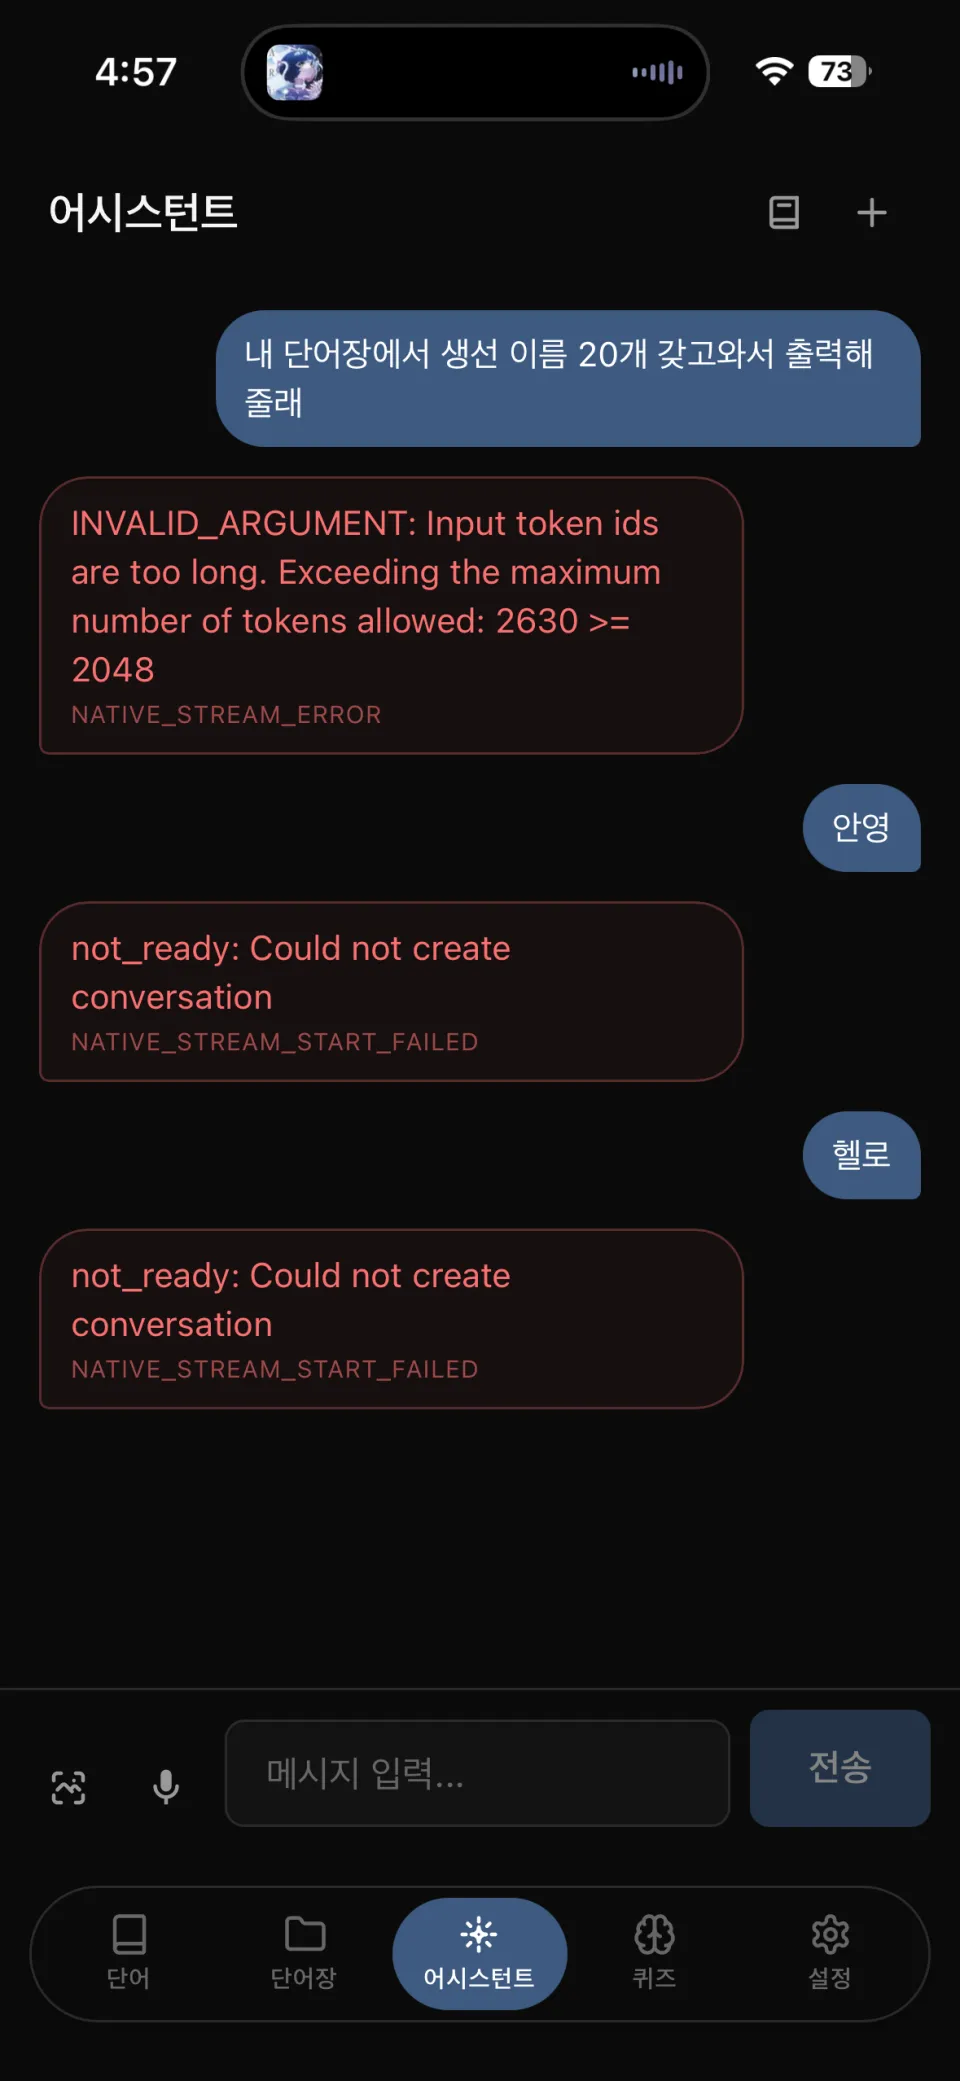
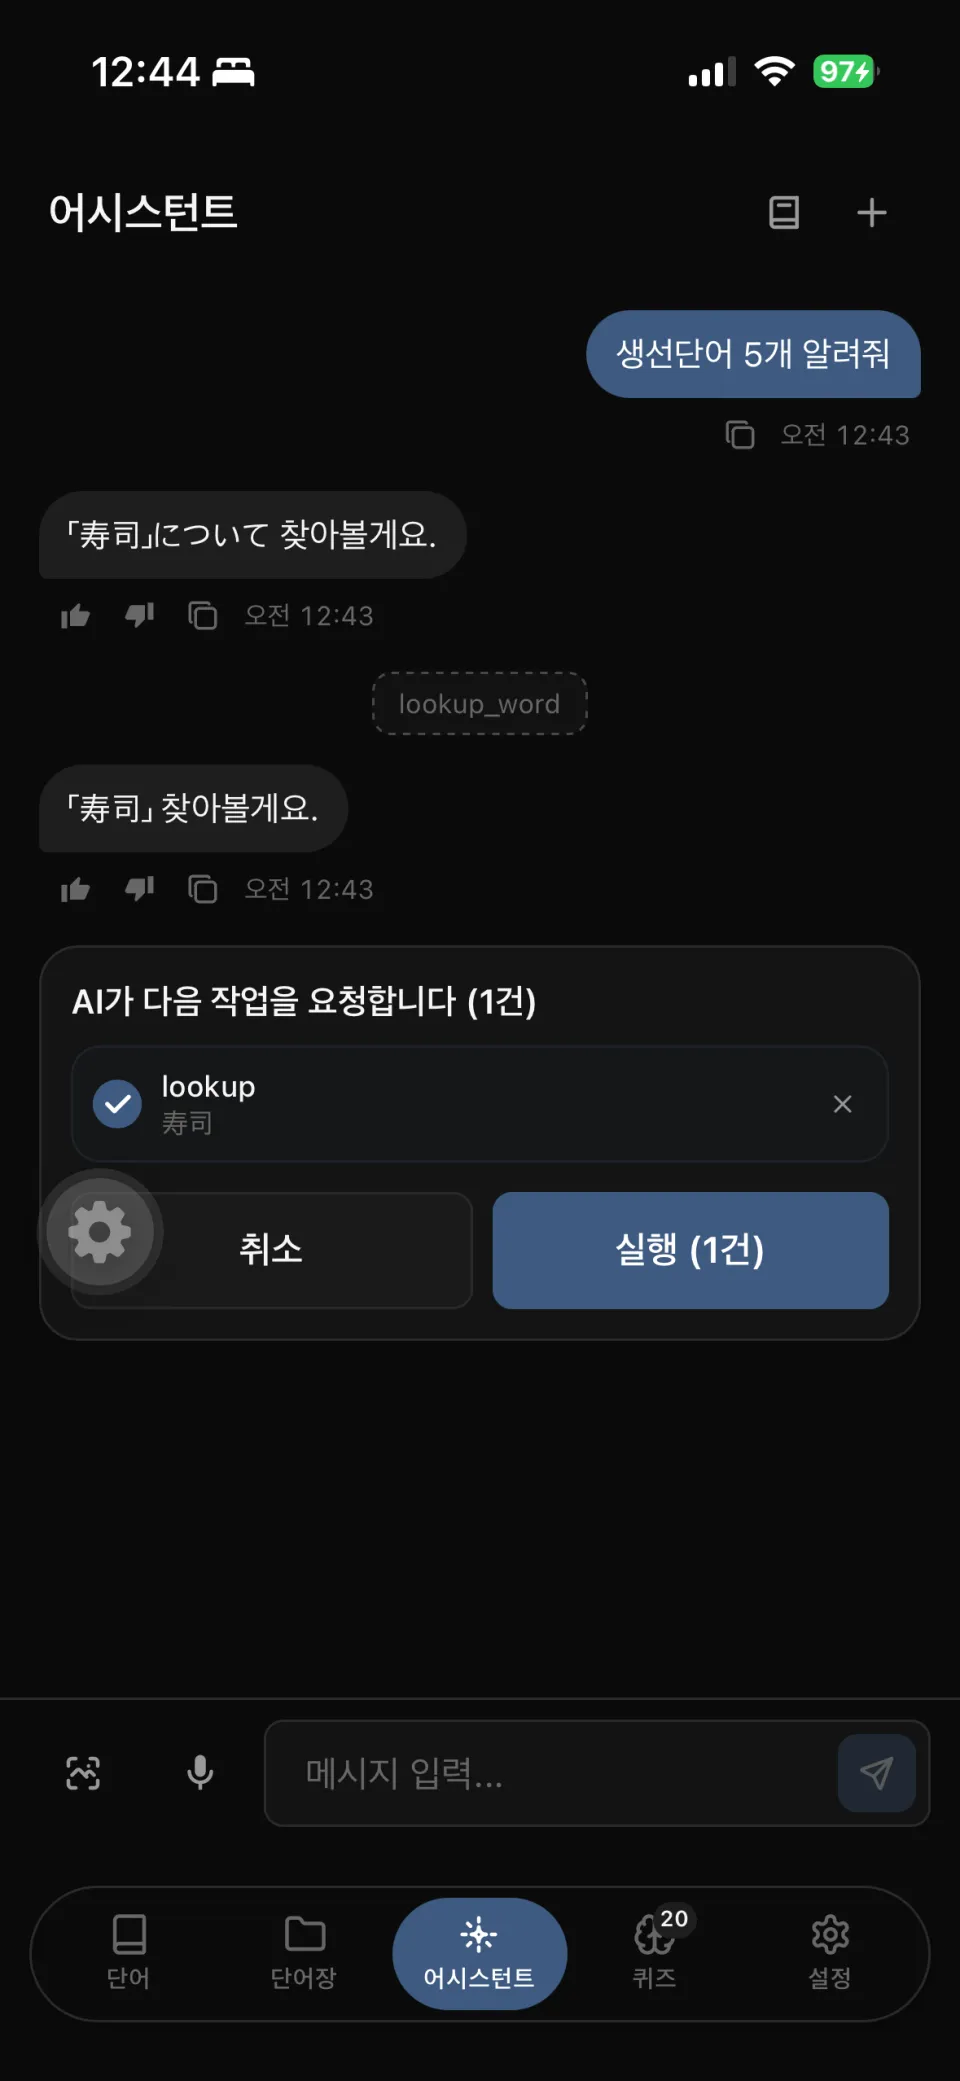
オンデバイスLLMが実際にどう動かなかったかは、画面に残っています。入力が少し長くなるだけでトークン上限(2048)を超えて切れ、セッションそのものが開かないこともよくありました。
| トークン上限超過・セッション作成失敗 | function callingの試行 |
|---|---|
 |  |
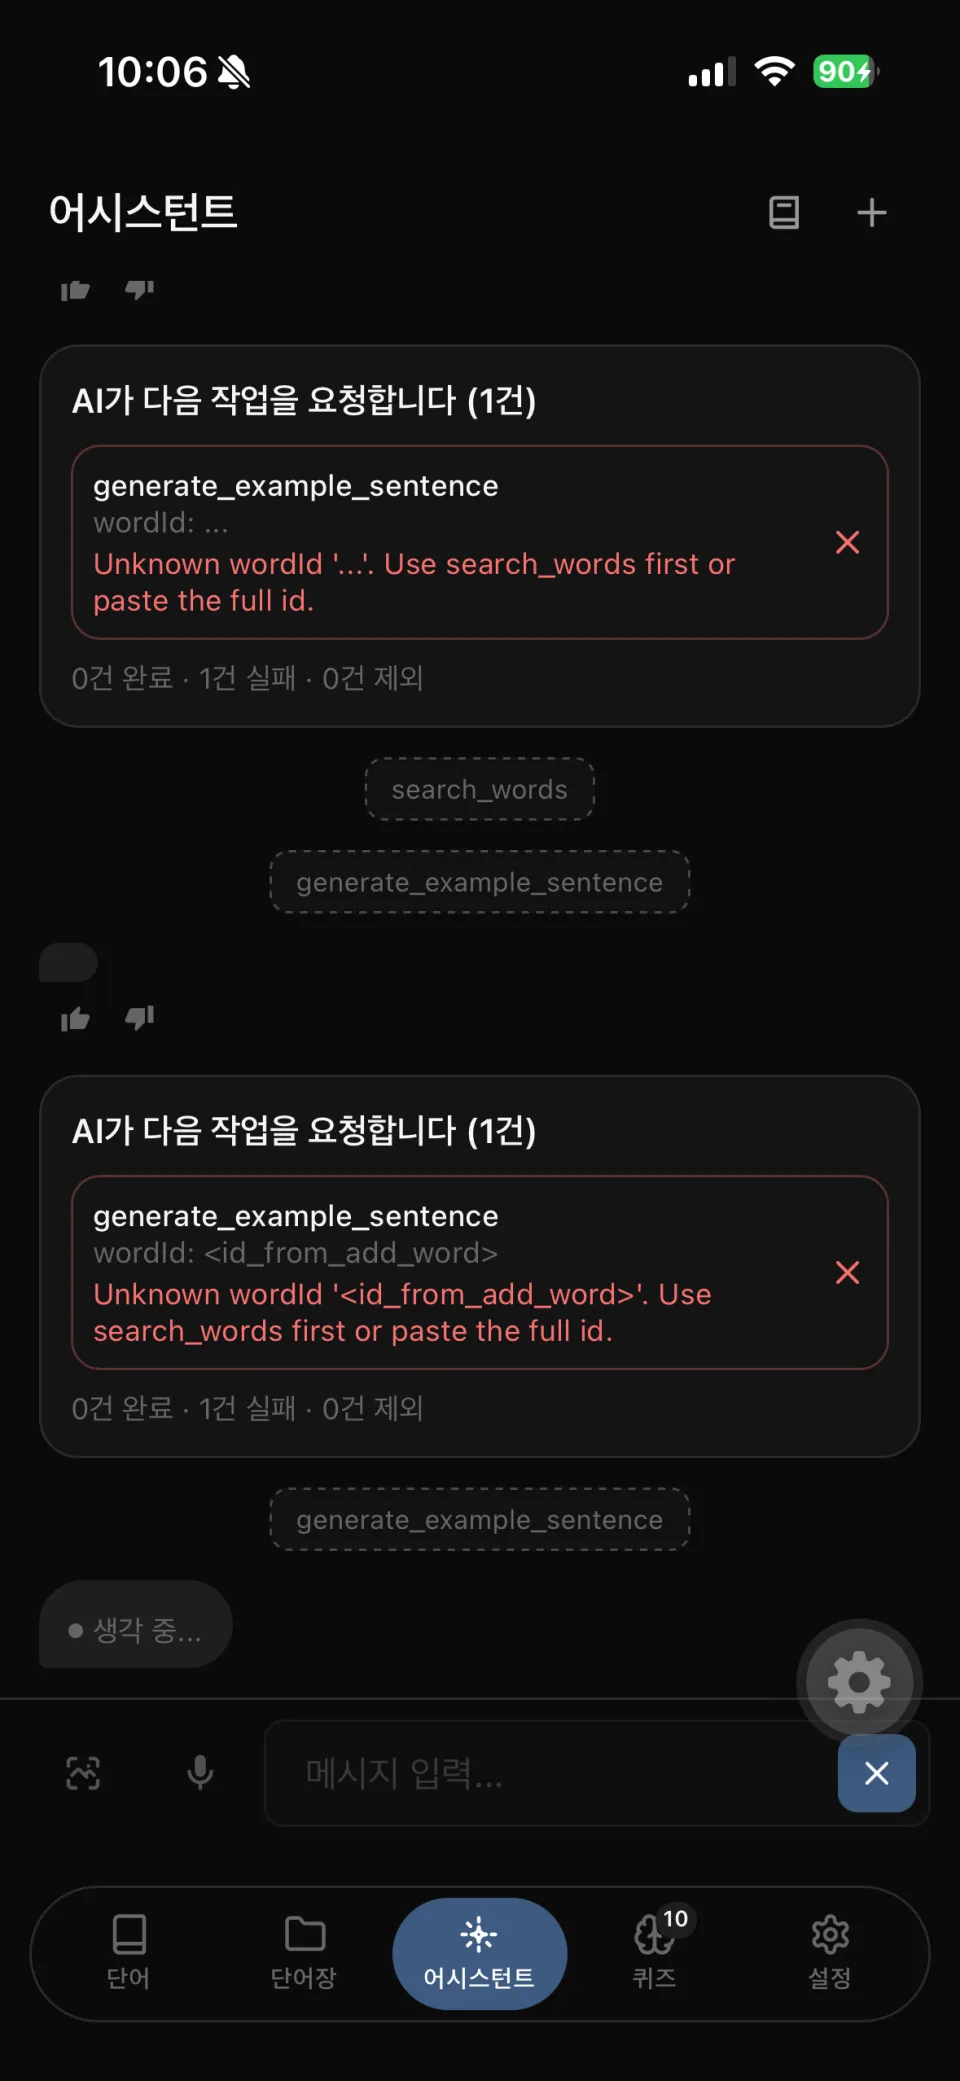
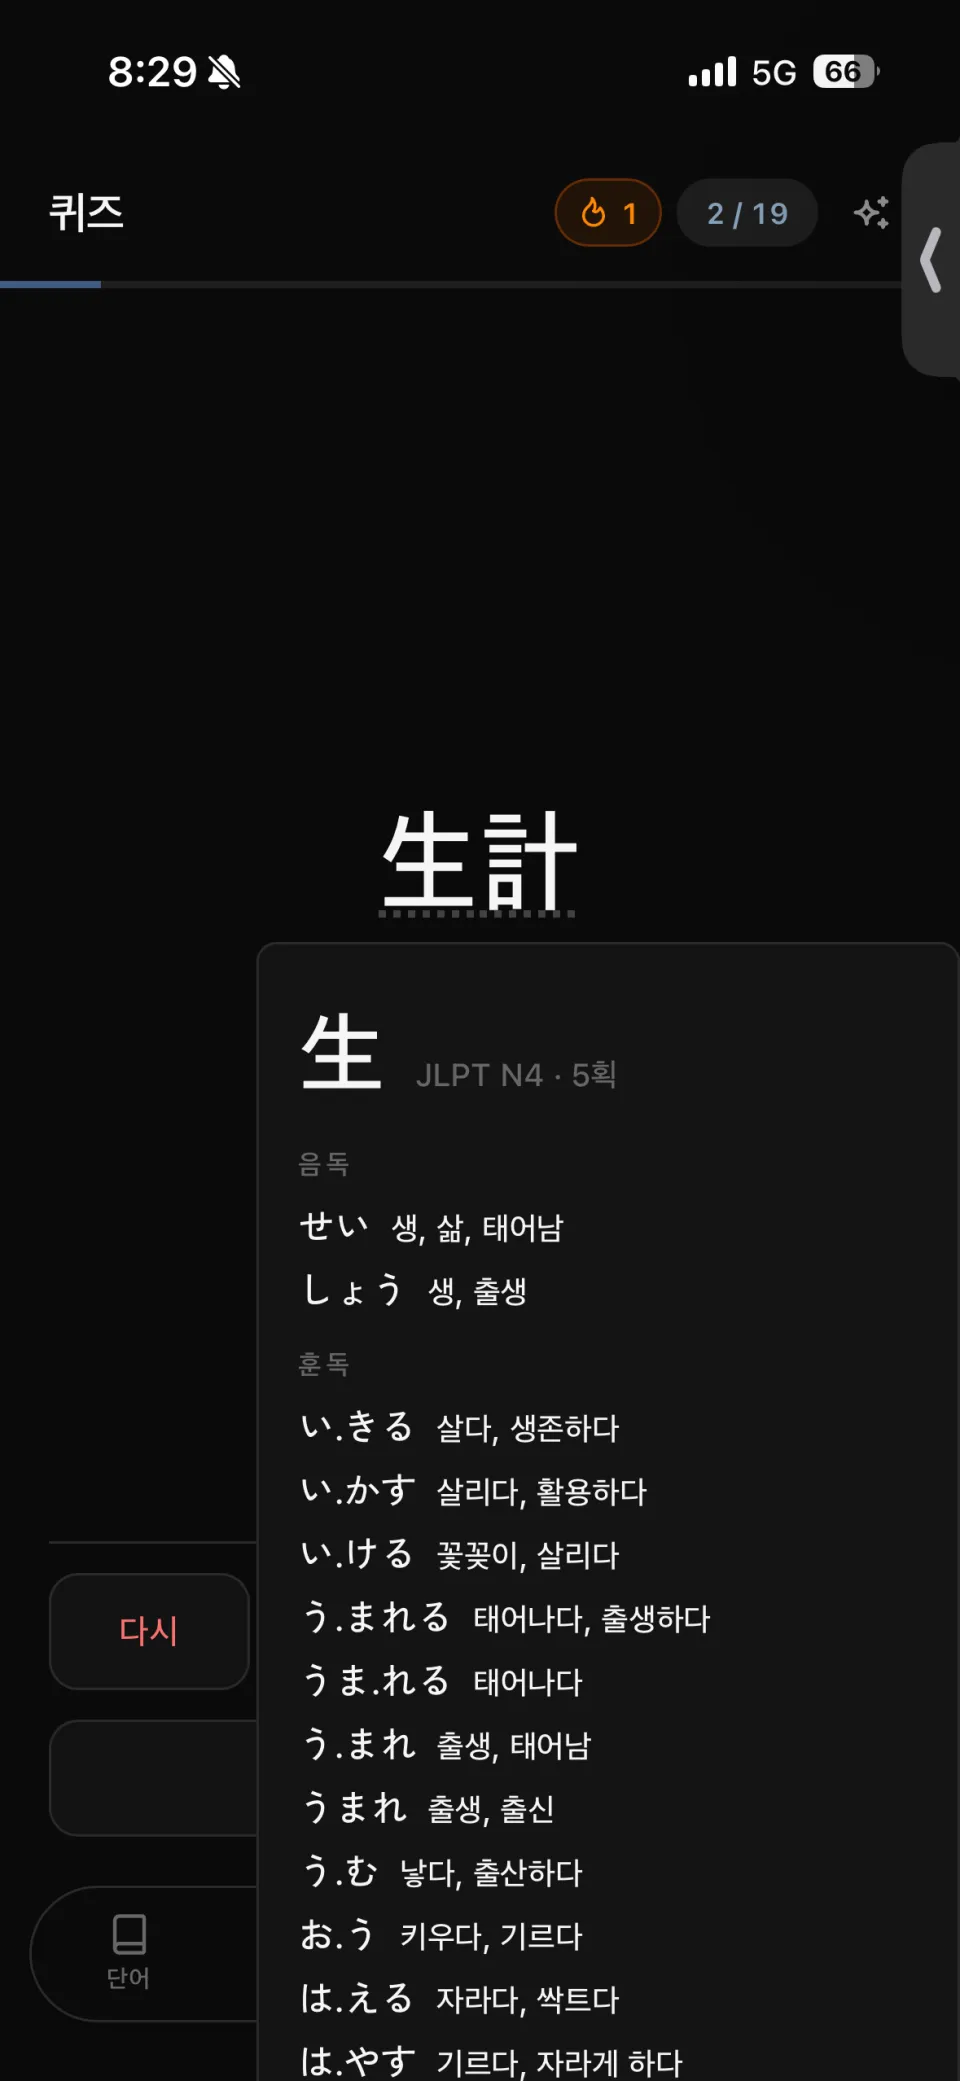
「動く」と「検証した」の違いは、こんな形でも現れました。漢字の詳細パネルが評価ボタンを覆い、見た目は正常でも実際には回答を選べませんでした。
| 応答失敗 | パネルが評価ボタンを隠した画面 |
|---|---|
 |  |